Подивімося, як dbt керує потоком і документацією для нас.
Список статей
- Спробуймо dbt. Частина 1 — пролог
- Спробуймо dbt. Частина 2 — перший запуск
- Спробуймо dbt. Частина 3 — seed і source
- Спробуймо dbt. Частина 4 — матеріалізація моделей
- Спробуймо dbt. Частина 5 — від Jinja до макросів і хуків
- Спробуймо dbt. Частина 6 — snapshots і analyses
- Спробуймо dbt. Частина 7 — тести
- Спробуймо dbt. Частина 8 — DAG і документація
- Спробуймо dbt. Частина 9 — змінні
- Спробуймо dbt. Частина 10 — пакети
- Спробуймо dbt. Частина 11 — SQLFluff і Pre-Commit
Документація теж важлива. Ми щось розробили, але якщо ніхто не може цього зрозуміти навіть прочитавши нашу документацію, то це не хороший продукт.
Перелік моделей
DAG означає спрямований ациклічний граф. Моделі вибудовуються, як річка: першу модель використовує друга, і так далі.
dbt може показати нам створені моделі за допомогою команди.
dbt lsЦя команда виведе список усіх наших моделей.
Наприклад, у нас є моделі в таких зв’язках:
Ми повинні побачити такий результат:
$ dbt ls

bbz_dbt_test_project.students.high_grade_stem_students
bbz_dbt_test_project.students.low_grade_stem_students
bbz_dbt_test_project.students.non_stem_students
bbz_dbt_test_project.students.rep_students
bbz_dbt_test_project.students.stem_students
source:bbz_dbt_test_project.students.student_gradesВибір моделей
Є кілька прапорців, які дають змогу одразу вибрати потрібні моделі для команди.
Фільтр
У dbt ми можемо просто вибирати або виключати окремі моделі за допомогою прапорця --select та/або --exclude, коли виконуємо такі команди, як ls, build, run, test тощо.
# select
dbt ls --select <model name, path, state, tag, package, etc.>
dbt ls -s <model name, path, state, tag, package, etc.>

# exclude
dbt ls --exclude <model name, path, state, tag, package, etc.>Графовий оператор
Ми можемо використовувати + як графовий оператор, щоб визначити кількість предків (батьківських моделей) і нащадків (дочірніх моделей), а @ — для вибору всіх моделей, пов’язаних із вибраною моделлю.
Наприклад:
# select a model and 1-level ancestors
dbt ls -s 1+model

# select a model and 3-level ancestors
dbt ls -s 3+model

# select a model and all level ancestors
dbt ls -s +model

# select a model and 1-level descendants
dbt ls -s model+1

# select a model and 3-level descendants
dbt ls -s model+3

# select a model and all level descendants
dbt ls -s model+

# select a model and 1-level ancestors plus 1-level descendants
dbt ls -s 1+model+1

# select a model and 3-level ancestors plus 3-level descendants
dbt ls -s 3+model+3

# select a model and all level ancestors plus all level descendants
dbt ls -s +model+

# select a model and all level ancestors plus all level descendants plus all level dependencies
dbt ls -s @modelДеякі приклади
Одна модель
$ dbt ls -s high_grade_stem_students

bbz_dbt_test_project.students.high_grade_stem_studentsДокументація
Ми побачили, як перелічувати та вибирати моделі. А ще dbt вміє генерувати документацію, з якою моделі легко зрозуміти.
У dbt є 2 команди для документації.
dbt docs generate
dbt docs serveЗа кілька секунд документація відкриється в браузері.
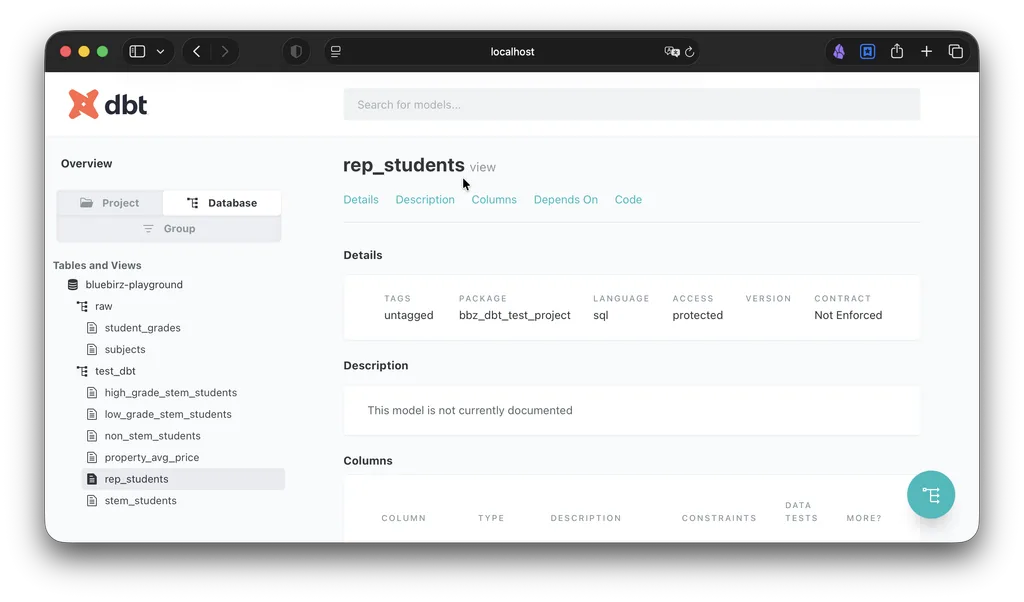
Тут ми можемо поекспериментувати й переглянути родовід кожної моделі.
Підсумок
dbt ls— для переліку моделей--select— для вибору моделей--exclude— для виключення моделей- прапорці вибору можна використовувати з
ls,compile,run,build,testтощо +— щоб розширити вибір моделей@— щоб вибрати весь зв’язок від вибраних моделей, включно з усіма предками, нащадками та залежностямиdbt docs generateіdbt docs serve— для створення й перегляду документації
Джерела
ОРИГІНАЛ СТАТТІ: Let’s try: dbt part 8 – DAGs and docs
АВТОР СТАТТІ: bluebirz
Оригінал опубліковано під ліцензією CC BY 4.0. Цей матеріал є перекладом українською мовою.
Доєднуйтесь до наших спільнот 👇
Один коментар до “Let`s try: dbt Частина 8 — DAG і документація”