Перш ніж трансформувати дані, нам потрібне джерело даних.
dbt дозволяє налаштовувати джерела даних (sources) у YAML-файлах. Також він підтримує завантаження даних за допомогою механізму seed.
Список статей
- Спробуймо dbt. Частина 1 — пролог
- Спробуймо dbt. Частина 2 — перший запуск
- Спробуймо dbt. Частина 3 — seed і source
- Спробуймо dbt. Частина 4 — матеріалізація моделей
- Спробуймо dbt. Частина 5 — від Jinja до макросів і хуків
- Спробуймо dbt. Частина 6 — знімки та аналізи
- Спробуймо dbt. Частина 7 — тести
- Спробуймо dbt. Частина 8 — DAG і документація
- Спробуймо dbt. Частина 9 — змінні
- Спробуймо dbt. Частина 10 — пакети
- Спробуймо dbt. Частина 11 — SQLFluff і Pre-Commit
Seed
Seed — це CSV-файли, дані з яких ми хочемо завантажити до таблиць у сховищі даних. Хоча dbt поступається спеціалізованим інструментам інтеграції даних, таким як Apache Airflow, іноді для завантаження даних можна використовувати й цю можливість.
Найкраще використовувати seed для завантаження невеликих статичних наборів даних, наприклад довідників, даних для порівняння або тестування, які знадобляться на наступних етапах трансформації.
Підготовка seed
Припустимо, у мене є файл person.csv, дані з якого я хочу завантажити до сховища даних. Для цього потрібно створити файл конфігурації такого вигляду.[1]
file tree
dbt_proj01/seed
├── person.csv
└── seed.ymlperson.csv
Я підготував невеликий набір даних, як показано нижче.
id,first_name,last_name,gender,occupation
1,Kenneth,Farrell,M,Product manager
2,Kimberly,Hood,F,Social worker
4,Robert,Haley,M,"Designer, jewellery"
5,Christine,Valentine,F,Barrister
7,Elizabeth,Espinoza,F,Solicitorseed.yml
Тепер налаштуємо seed для завантаження даних.
- Я ввімкнув цей seed.
- Я хочу завантажити дані до схеми raw (dataset у BigQuery).
- Я хочу перейменувати таблицю на
person_occupation. - Для цього файлу потрібно ввімкнути використання лапок для назв стовпців.
- Цей файл має такі стовпці.
version: 2

seed:
  - name: person
    config:
      enabled: true
      schema: raw
      alias: person_occupation
      quote_columns: true
      column_types:
        id: int64
        first_name: string
        last_name: string
        gender: string
occupation: stringЗавантаження початкових значень
Використовуйте цю команду:
dbt seedЯкщо завантаження seed пройде успішно, у журналі з’явиться відповідне повідомлення.
20:47:41  Running with dbt=1.10.13
20:47:42  Registered adapter: bigquery=1.10.2
20:47:43  Unable to do partial parsing because change detected to override macro. Starting full parse.
20:47:43  Found 2 models, 1 seed, 4 data tests, 509 macros
20:47:43
20:47:43  Concurrency: 1 threads (target='dev')
20:47:43
20:47:48  1 of 1 START seed file dbt_test_dataset_raw.person_occupation .................. [RUN]
20:47:53  1 of 1 OK loaded seed file dbt_test_dataset_raw.person_occupation .............. [INSERT 5 in 5.19s]
20:47:53
20:47:53  Finished running 1 seed in 0 hours 0 minutes and 9.94 seconds (9.94s).
20:47:53
20:47:53  Completed successfully
20:47:53
20:47:53 Done. PASS=1 WARN=0 ERROR=0 SKIP=0 NO-OP=0 TOTAL=1Також перевірте, чи створилася таблиця із завантаженими даними.
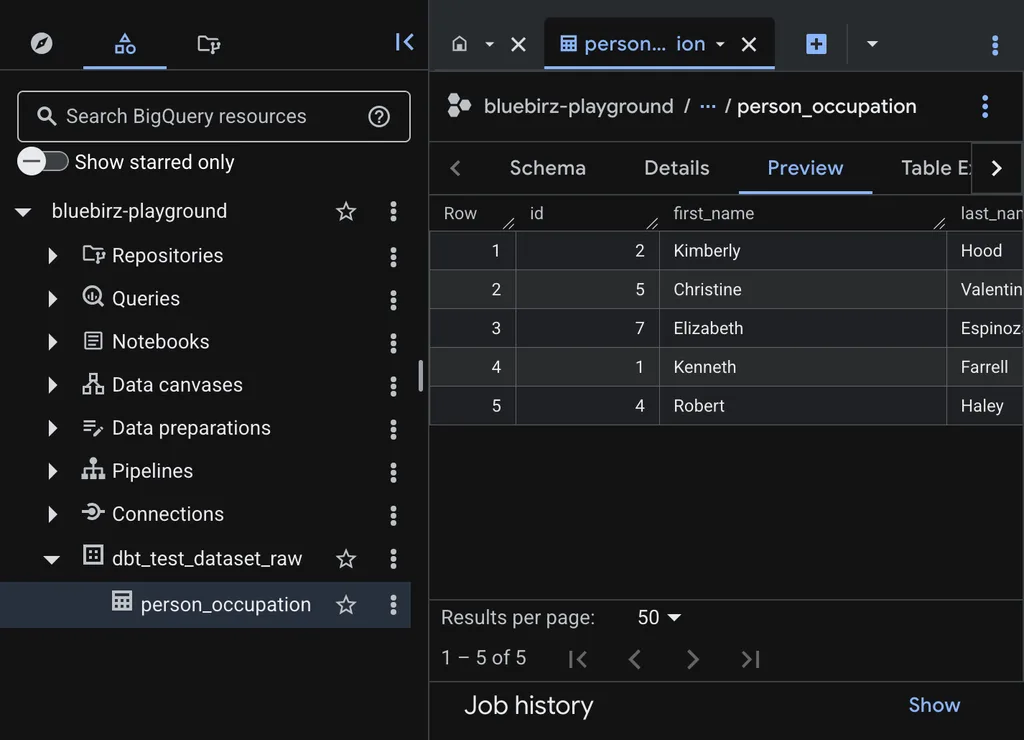
Однак ми хотіли, щоб назва схеми (dataset) була raw, а отримали dbt_test_dataset_raw. Потрібно змінити стандартну поведінку dbt.
Перевизначення назви схеми
Згідно з документацією dbt[2], якщо ми задаємо значення параметра schema, воно не замінює назву схеми за замовчуванням із profile.yml, а додається до неї.
Для цього потрібно створити макрос, який змінить стандартну поведінку dbt.
file tree
Ми створюємо новий файл із назвою generate_schema_name.sql для опису цієї дії у каталозі macros/.
dbt_proj01/macros
└── generate_schema_name.sqlmacro
Напишіть код, як показано нижче. Цей фрагмент Jinja означає, що:
- якщо схема не вказана, буде використано схему за замовчуванням.
- якщо схема вказана, введені дані будуть використані без змін.
{% macro generate_schema_name(custom_schema_name, node) -%}

    {%- set default_schema = target.schema -%}
    {%- if custom_schema_name is none -%}

        {{ default_schema }}

    {%- else -%}

        {{ custom_schema_name | trim }}

    {%- endif -%}

{%- endmacro %}Запустіть dbt seed ще раз.
$ dbt seed

20:52:19  Running with dbt=1.10.13
20:52:21  Registered adapter: bigquery=1.10.2
20:52:21  Unable to do partial parsing because change detected to override macro. Starting full parse.
20:52:21  Found 2 models, 1 seed, 4 data tests, 509 macros
20:52:21
20:52:21  Concurrency: 1 threads (target='dev')
20:52:21
20:52:26  1 of 1 START seed file raw.person_occupation ................................... [RUN]
20:52:33  1 of 1 OK loaded seed file raw.person_occupation ............................... [INSERT 5 in 6.71s]
20:52:33
20:52:33  Finished running 1 seed in 0 hours 0 minutes and 11.17 seconds (11.17s).
20:52:33
20:52:33  Completed successfully
20:52:33
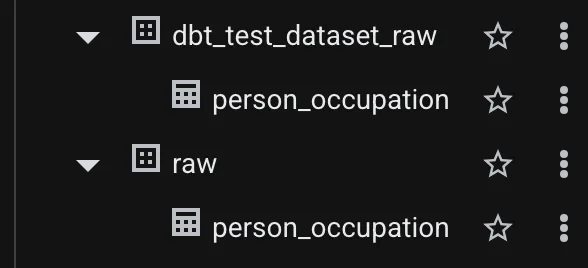
20:52:33 Done. PASS=1 WARN=0 ERROR=0 SKIP=0 NO-OP=0 TOTAL=1Перевіримо, і тепер ми маємо набір даних raw, як і очікувалося.
Використання seed у моделях
Ми завантажили набори даних, тому тепер можемо використовувати їх у наших моделях.
Припустимо, я хочу, щоб модель відбирала записи про всіх жінок. Для цього можна використати такий запит.
SELECT *
FROM {{ ref('person') }}
WHERE gender = 'F'Ми використовуємо {{ ref(“seed_name”) }} для посилання на таблиці початкових значень.
Компіляція моделей
Давайте подивимося на результат компіляції:
$ dbt compile

15:21:22  Running with dbt=1.10.13
15:21:23  Registered adapter: bigquery=1.10.2
15:21:24  Found 1 seed, 3 models, 4 data tests, 509 macros
15:21:24
15:21:24  Concurrency: 1 threads (target='dev')
15:21:24
Compiled node 'woman_jobs' is:
SELECT *
FROM `bluebirz-playground`.`raw`.`person_occupation`
WHERE gender = 'F'Як зазначено вище, dbt підставляє у нашу модель правильну таблицю початкових значень (рядок № 11).
Sources (джерела)
Джерела (sources) — це наявні таблиці або представлення у сховищах даних, до яких ми хочемо звертатися в запитах. Оскільки ці об’єкти вже існують, у конфігурації dbt потрібно лише вказати, де саме вони розташовані.
Припустимо, у наборі даних raw у BigQuery у мене вже є таблиця books.
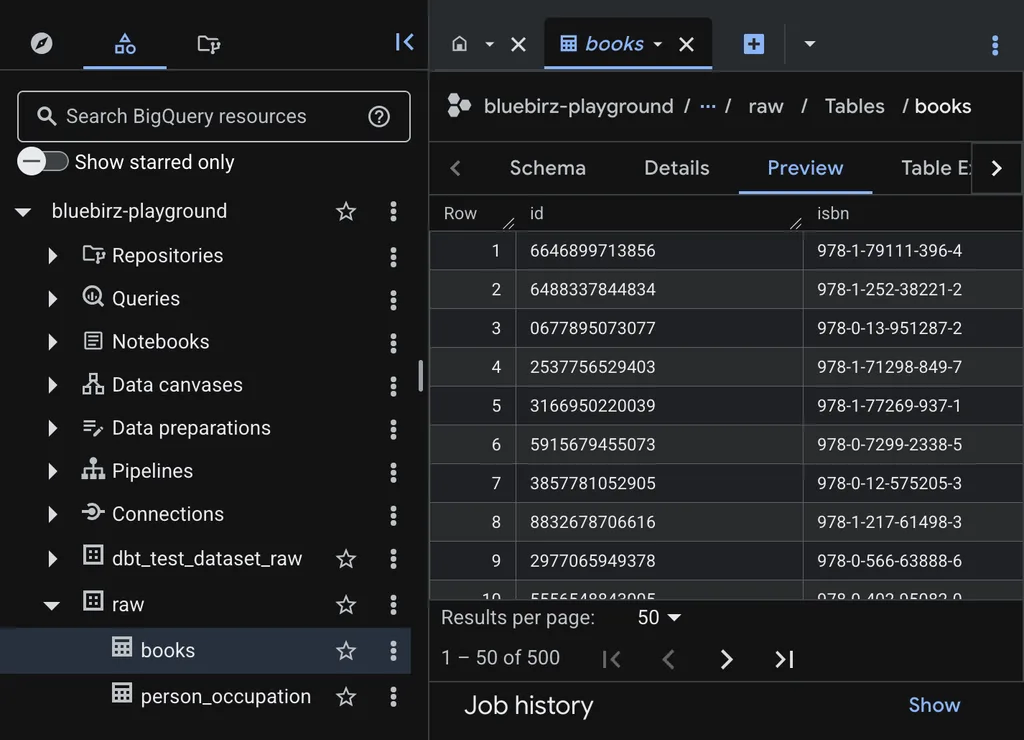
Схема таблиці books має такий вигляд.
[
  {"name": "id", "type": "STRING", "mode": "NULLABLE"},
  {"name": "isbn", "type": "STRING", "mode": "NULLABLE"},
  {"name": "title", "type": "STRING", "mode": "NULLABLE"},
  {"name": "author", "type": "STRING", "mode": "NULLABLE"},
  {"name": "published_year", "type": "INTEGER", "mode": "NULLABLE"}
]Тепер потрібно створити нову таблицю, яка міститиме кількість книг, виданих у кожному десятилітті до 2000 року.
Підготовка джерел і моделей
Для цього потрібно створити конфігураційні файли [3] і файли із SQL-запитами, як показано нижче.
file tree
Створимо конфігураційний файл і файл запиту в каталозі books/.
models/books
├── old-books-by-decade.sql
└── source-books.ymlconfigs
Ось конфігураційний файл для джерела даних (source). Я називаю його raw_data, прив’язую до схеми (dataset) raw і вказую таблицю books.
version: 2

sources:
  - name: raw_data
    schema: raw
    tables:
      - name: books
description: all books in my librarymodel
Цей запит визначає десятиліття видання кожної книги, опублікованої до 2000 року, а потім підраховує кількість книг із джерела raw_data.books.
{{-
  config(
    materialized='table',
    schema='transform'
  )
-}}

SELECT
    SAFE_CAST(FLOOR(published_year / 10) * 10 AS INT64) AS decade,
    COUNT(*) AS book_count
FROM {{ source('raw_data', 'books') }}
WHERE published_year < 2000
GROUP BY decade- Ця модель буде матеріалізована як таблиця, як налаштовано в блоці
{{ config() }}. - Я вказав
schema='transform', тож ця таблиця буде створена в схеміtransform. - Додайте
-у Jinja-блоці, щоб прибрати пробіли на початку/в кінці:{{- ... -}}.
Компіляція моделей
Тепер подивімося, який вигляд має підсумковий SQL-запит після виконання команди dbt compile.
$ dbt compile

18:18:43  Running with dbt=1.10.13
18:18:45  Registered adapter: bigquery=1.10.2
18:18:45  Found 3 models, 2 seed, 4 data tests, 1 source, 509 macros
18:18:45
18:18:45  Concurrency: 1 threads (target='dev')
18:18:45
Compiled node 'old-books-by-decade' is:
SELECT
    SAFE_CAST(FLOOR(published_year / 10) * 10 AS INT64) AS decade,
    COUNT(*) AS book_count
FROM `bluebirz-playground`.`raw`.`books`
WHERE published_year < 2000
GROUP BY decadeЧудово! Запит має правильний вигляд.
Запуск моделей
Тепер можна виконати модель за допомогою dbt.
$ dbt run

18:18:50  Running with dbt=1.10.13
18:18:51  Registered adapter: bigquery=1.10.2
18:18:52  Found 3 models, 2 seed, 4 data tests, 1 source, 509 macros
18:18:52
18:18:52  Concurrency: 1 threads (target='dev')
18:18:52
18:18:53  1 of 1 START sql table model transform.old-books-by-decade ..................... [RUN]
18:18:57  1 of 1 OK created sql table model transform.old-books-by-decade ................ [CREATE TABLE (10.0 rows, 3.9 KiB processed) in 3.93s]
18:18:57
18:18:57  Finished running 1 table model in 0 hours 0 minutes and 4.48 seconds (4.48s).
18:18:57
18:18:57  Completed successfully
18:18:57
18:18:57 Done. PASS=1 WARN=0 ERROR=0 SKIP=0 NO-OP=0 TOTAL=1Перегляньмо отриману таблицю в BigQuery.
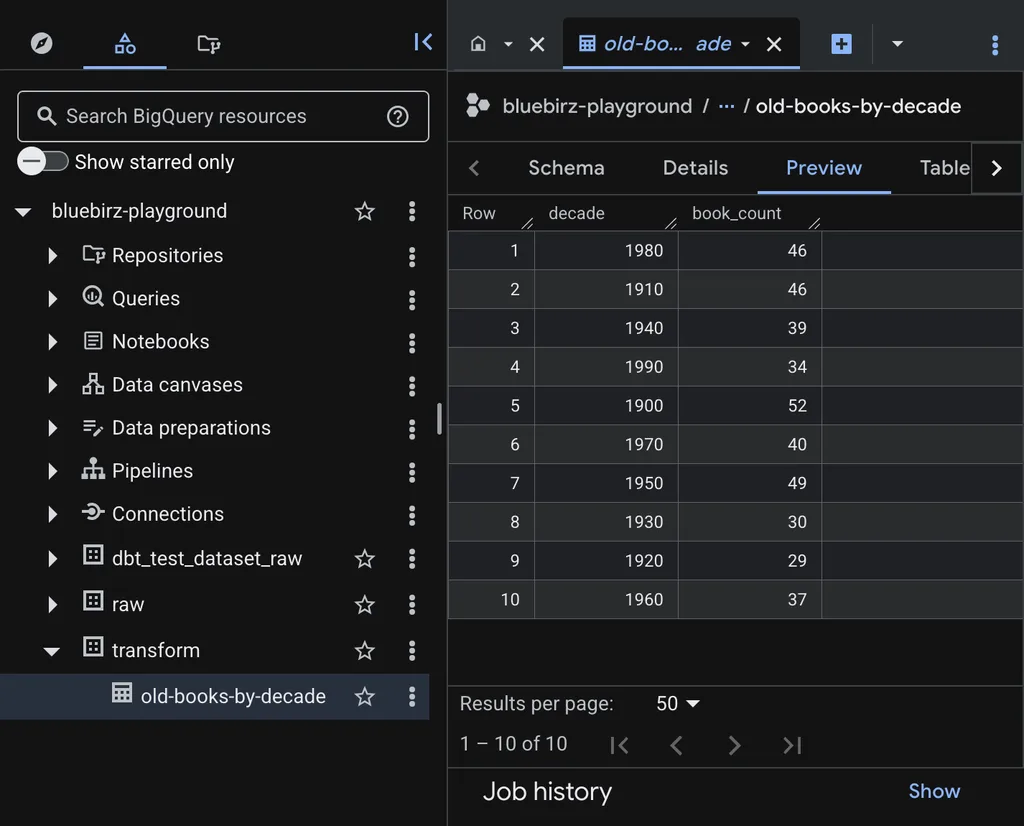
Модель успішно виконалася.
Підсумок
seed:
- розмістіть CSV-файли в каталозі
seed/; - визначте YAML-конфігурації в такому синтаксисі:
version: 2

seed:
  - name: <seed_name>
    config:
      enabled: <true|false>
      schema: <schema>
      alias: <alias>
      quote_columns: <true|false>
      column_types:
<column_name>: <data_type>- виконайте
dbt seed, щоб завантажити seed; - посилайтеся на seed у моделях через
{{ ref('<seed_name>') }}. - Щоб змінити стандартну поведінку формування назви схеми, створіть макрос
generate_schema_name.sqlіз використанням Jinja, як показано вище. - Sources:
- визначте YAML-конфігурації в такому синтаксисі:
version: 2

sources:
  - name: <source_name>
    schema: <schema>
    tables:
      - name: <table_name>
description: <description>- використовуйте
{{ source('<source_name>', '<table_name>') }}, щоб посилатися на таблицю source у моделі; - Щоб створювати таблицю замість представлення, використовуйте в моделі конфігурацію
{{ config(materialized='table') }}. - Щоб створити таблицю в конкретній схемі (dataset), використовуйте в моделі конфігурацію
{{ config(schema='<schema_name>') }}. - Компілюйте всі моделі командою
dbt compile. - Запускайте всі моделі командою
dbt run.
Джерела
- Конфігурації seed | dbt Developer Hub
- Як dbt формує ім’я схеми моделі?
- Конфігурації джерел | dbt Developer Hub
ОРИГІНАЛ СТАТТІ: Let’s try: dbt part 3 – seed and source
АВТОР СТАТТІ: bluebirz
Оригінал опубліковано під ліцензією CC BY 4.0. Цей матеріал є перекладом українською мовою.
Доєднуйтесь до наших спільнот 👇