
Привіт, data-life-ua! Сьогодні хочу розповісти про Data-фахівців і познайомити вас з нашою командою Data Platform.
Які Data-фахівці бувають
Якщо зараз зайти на будь-який кар’єрний сайт і пошукати вакансії за словом Data, то пошук видасть результати на десятки сторінок. Ось лише кілька прикладів:
- Data Engineer,
- Data Analyst,
- Data Scientist,
- Data Architect,
- Data Solution Architect,
- Data Integration Manager,
- Big Data Engineer,
- Data Manager,
- Data Platform Team Lead,
- Data Officer,
- Data Steward.
Також у фахівців можуть бути різні рівні: Junior / Middle / Senior. Що спільного у цих ролей? Правильно — Data. Це слово вказує на приналежність інженерів до окремого «клубу» фахівців.
Приблизно 20-25 років тому фахівців, які працюють з базами даних, називали просто DBA (Database Administrator). DBA поєднував відразу кілька ролей, він:
- був розробником функціонального коду в базі даних (Database Developer);
- займався проектуванням моделей даних (Database Modeler);
- оптимізував SQL-запити та роботу СУБД в цілому (Performance Tuning Engineer);
- підтримував реплікації між залученими вузлами топології бази даних (Database Administrator);
- обслуговував кластери баз даних (Database Administrator);
- стежив за індексами / табличними просторами / статистикою / Data-файлами (Database Administrator);
- збирав вимоги для нових фіч проекту (Data Analyst);
- і нарешті — писав самі SQL-запити будь-якої складності (SQL Developer).
Словом, був таким «єдинорогом», який вміє все. Потім на допомогу реляційним прийшли нереляційні бази даних, з’явилося поняття Big Data, все ускладнилося за ролями інженерів 🙂
Найпростіше пояснювати на прикладах, тому розповім, які Data-фахівці та команди є у нас в Quadcode.
Data-команди та фахівці в Quadcode
У нас є команда Data Platform — окрема група інженерів. Ролі в команді різні, але кожна доповнює іншу так, щоб ми могли виконувати будь-які завдання, пов’язані з даними.
Команда Data Platform забезпечує функціонування нашого LakeHouse, який схематично зображений нижче:
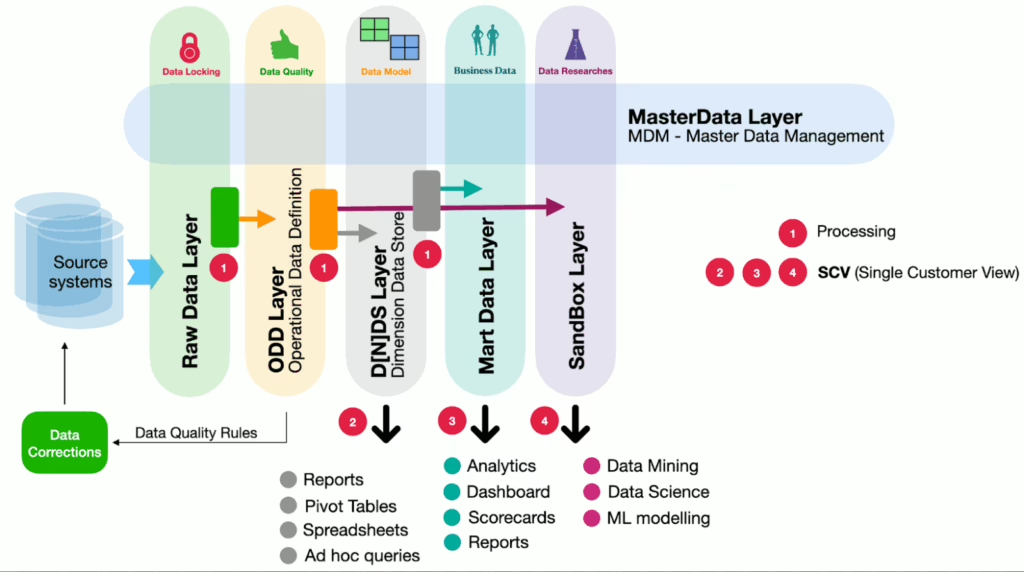
Команда складається з 4 великих стеків:
1. Data Quality — фахівці, які перевіряють якість даних, ця роль у нашій компанії знаходиться на межі між Data Engineering / Data Science (Data Mining) / Data Analytics. Це інженери, які, з одного боку, мають теоретичні знання: що таке бази даних, запити до даних, підходи до аналітики, до статистики даних, до патерну MapReduce.
А з іншого боку — практичні навички. Наприклад, вони проводять автоматичне і ручне тестування з перевірки якості даних, роблячи перехресні перевірки між джерелом і сховищем холодного шару в LakeHouse з використанням випадкових вибірок (data samples) і ймовірнісних структур сімейства Bloom Filters. Покриття тестами наших даних — вже життєва необхідність, це потрібно, щоб, наприклад, один із щомісячних звітів до регуляторних організацій зводився до прийнятних чисел і відповідав вимогам.
Приклад практичного завдання: порівняти дві таблиці. Одна знаходиться в джерелі (наприклад, в мікросервісі digital-опціонів), а друга — у нас у вертикальній базі даних (наприклад, в Greenplum), яка розташована в логічному шарі Operational Data Store. Потрібно порівнювати дані в цих двох таблицях практично безперервно, щоб не було втрати висококритичної інформації. Це особливо важливо, якщо ви працюєте у фінтеху: втрата однієї транзакції може вилитися у великі фінансові (а також репутаційні) втрати.
У разі невідповідності даних Data Quality Engineers знаходять причину і готують план відновлення втраченого сенсу даних (це може бути як фізична втрата даних, так і неузгоджена зміна логіки на стороні команди мікросервісу). При необхідності залучають до цієї роботи Data-фахівців, таких як Data Stewards, Data Owners, Data Engineers.
Але якість даних — це не тільки порівняння по рядках (один в один). Іноді ця операція обходиться занадто дорого через кількість джерел, обсяги самих даних і періодичні міграції моделей даних. Як одне з можливих рішень — використання метрик за якістю в довірчому інтервалі, заснованих на правилах «6 сигм» (Six Sigma Rules).

І потім залучення всієї необхідної математики для аналізу Confidence Interval і false-positive спрацьовувань.

2. Data Engineers і Big Data Engineers — це фахівці команди Data Platform, які працюють з конкретними фізичними двигунами баз даних, ETL-процесами (з урахуванням процесу Back-Filling), чергами повідомлень, процесами нормалізації, трансформації, стандартизації, гармонізації, обфускації даних. Слово Big означає, що інженер має глибокий практичний досвід роботи в екосистемах формату Hadoop.
Ось один із прикладів Data Pipeline, який «приводить» дані з джерела в одне зі сховищ Operational Data Store шару:

На малюнку все логічно і зрозуміло. Але, наприклад, одне із завдань дата-інженерії — мутація / міграція / зміни схеми на джерелі — досить цікаве. Упевнений, всі знають термін Schema Registry. Але виникає маса нюансів: як це організувати так, щоб мінімізувати людський фактор, бути проактивними, і LakeHouse функціонував у максимально автоматичному режимі (перебудовуючи необхідні трансформації даних на всіх залучених логічних шарах автоматично). Скажу чесно, ми на шляху до такої автоматизації, вже є план дій. У випадку Schema Registry ми вибрали одночасно push- і pull-підходи, використовуючи Kafka Confluent і метапавуків (meta-crawlers), які організовані в окремому логічному шарі MDM.

В окремій технічній статті я планую розповісти про технічну реалізацію шару MDM і його роль в нашому LakeHouse.
3. Data Architect — людина, яка займається проектуванням кожного з логічних шарів, розумінням поточної архітектури та накопиченої історії процесів. При цьому Datа Architect трохи програмує, робить MVP завдань, вивчає поточні рішення на ринку, спілкується з командами та фахівцями, може проводити навчання (у нас в Quadcode так). Мета його роботи — максимально структурувати потоки даних в компанії і стандартизувати підходи для побудови (або зміни) моделі даних, щоб вона відповідала внутрішнім правилам і регламентам. Завдання дуже важливе, особливо з урахуванням нашого шляху до Data Governance (логічних правил і процесів з даними) і Data Management (фізичних правил роботи моделей на рівні мікросервісів). Ось, наприклад, одне із завдань: створення компонентів Data Lineage і Data Catalogue, вони використовуються для таких завдань, як визначення «родоводу» набору даних, який залучений до процесу перезбору даних / автоматичної перебудови моделей / пріоритезації процесу відновлення даних / надання формул переходу для атрибутів однієї матеріалізації до іншої.

Але є й інша сторона роботи Data Architect — це роль Service Owner, яка передбачає створення процесів роботи з даними, залучення необхідних інженерів та багато іншого.
4. Database Administrator — інженер, який знає бази даних зсередини, підбирає правильні параметри зберігання даних, фізичні диски, підказує, який індекс краще вибрати (можливо, індекс і зовсім не потрібен), стежить за розподілом даних у вузлах топології, стежить за метриками, моніторить бази даних, мігрує legacy монолітні таблиці в партиціоновані та/або субпартиціоновані, оптимізує запити, інтегрує дані з холодним шаром даних і вирішує багато інших завдань. Ось приклад частини архітектури, в рамках якої DBA-інженери виконують свою роботу:

Для роботи з OLAP-запитами ми в основному використовуємо Greenplum (це частина ODS і DDS логічних шарів), але також у нас є інстанси PostgreSQL, ClickHouse, Hive.

Історично склалося так, що у нас інженери Data Analytics і Data Science знаходяться в інших командах. Але це не означає, що ми працюємо окремо. У нас є спільні обговорення завдань і загальне квартальне планування. На цих зустрічах ми спілкуємося і намагаємося знайти спільне рішення.
Data Analytics займаються аналітикою, проводять різні експерименти з даними, перевіряють гіпотези тощо.
Команда Data Science займається алгоритмами, вивченням даних, пошуком взаємозв’язків, експериментами, аналізує результати А/B-тестування. Наприклад, одне із завдань — дослідження аномалій / викидів даних при виведенні грошових коштів (Outlier Detection).
У співробітників Quadcode є профілі посад — документи, в яких зафіксовані мета, завдання, навички, обов’язки, hard- та soft-skills, управлінські та корпоративні компетенції для кожної конкретної ролі. Ось, наприклад, частина інформації з профілів Data Engineer і Database Administrator. Прочитайте, ця інформація допоможе зрозуміти, що можуть очікувати роботодавці від співробітників на цих позиціях.
| Data Engineer | Database Administrator | |
| Ціль посади | Надання швидкого доступу аналітикам до точних та своєчасних даних. | Забезпечення процесингу та зберігання даних: — надання швидкого доступу аналітикам до точних та своєчасних даних; – Підтримка інфраструктури даних. |
| Основні завдання | – реалізація батчевого оброблювача для дотримання GDPR (очищення історії користувача); – Реалізація потокового компонента завантаження даних в ODD-шар зберігання Greenplum; – Написання ETL-процедур збору/очищення даних. | – Організація зберігання та процесингу даних; – Встановлення та підтримка аналітичного софту; – Оптимізація роботи баз даних. |
| Hard Skills | — володіння однією чи декількома мовами програмування для написання ETL-процедур (Python, Scala/Java, Golang); – розуміння принципів створення та роботи розподілених систем; – Досвід розробки batch-і streaming-додатків; – Досвід роботи з СУБД (Greenplum, PostgreSQL); – Навичка оптимізації SQL-запитів; – Досвід роботи з hadoop-екосистемою (HDFS, Hive, Flink); – Досвід роботи з брокерами повідомлень (Apache Kafka); – Досвід роботи з NoSQL БД (Apache Cassandra); – Навички роботи з OS Linux на рівні впевненого користувача. | – адміністрування СУБД: Greenplum, PostgreSQL, MySQL, ClickHouse; – Навички роботи з ОС Linux на рівні впевненого користувача; – знання принципів роботи мережевих протоколів (TCP/UDP, HTTP, ICMP та інших); — володіння однією чи декількома мовами програмування для написання інфраструктурних інструментів автоматизації роботи (Python, Scala/Java, Golang); – володіння інструментами системи керування конфігурацією (ansible/salt/chef/puppet). |
При цьому ми маємо в компанії мікросервісну архітектуру, а мікросервіси працюють зі своїми джерелами даних. Тому, крім команди Data Platform, дата-завдання займаються фахівці всередині інших команд.
Наприклад, команда білінгу: у неї свої бази даних, адміністратори та розробники баз даних. Вони працюють із OLTP-трафіком (Online Transaction Processing). Це означає, що трафік дуже швидкий (прийшов-пішов). Він приходить у базу даних у форматі «Дай мені дані за такий період», «Онови це котирування» або «Додай заявку від клієнта по digital-опціонам» тощо. OLTP-трафік характеризується великим TPS та невеликим значенням метрики latency. Чим швидше – тим більше клієнтів, більше клієнтів – вища лояльність, вища лояльність – більше прибутку. Все дуже взаємопов’язане.
Data-команди та фахівці: як будується робота
Є такий підхід до роботи з даними – Data Mesh. Сенс у тому, що за дані відповідає не тільки одна команда Data Platform, а всі команди, які дають дані. Мета — працювати з даними як із цінністю. Наприклад: команда білінгу надсилає дані Data Platform і відповідальна за їхню коректність. Дотримуючись підходу Data Mesh: команди, залучені до мікросервісної архітектури, повинні відповідати дані як продукт, як цінність. Не просто: “Я віддав дані Data-команді, на цьому все”, а: “Я несу відповідальність за дані, які надаю, за те, в якому вигляді ці дані в результаті надійдуть кінцевому споживачеві”. На перший погляд може здатися, що розробників “кидають у пекло”, а Data-команди ніяк не допомагають і ні за що не відповідають, але це не так. Ми маємо безліч концепцій, регламентів і так далі, які допомагають побудувати процес. Наведу кілька прикладів.
Концепція «Поїздів» . Не заглиблюватимуся у фреймворк SAFe, поясню буквально на пальцях. Щоб уникнути хаосу, всі команди, залучені до даних, повинні працювати злагоджено та пам’ятати про загальну цінність. Для вирішення цього завдання з’являється безліч концепцій, фреймворків та інструментів. Один із них — «поїзди». Суть: представники різних команд перемішуються і становлять окрему сутність (поїзд). Кожен поїзд має всі необхідні фахівці (архітектори, розробники, аналітики і так далі) і Product Owner. Це дозволяє команді працювати швидше та зменшити кількість блокерів. Тобто (повертаючись до теми статті) у кожній команді, яка працює з даними, з’являються фахівці, які можуть написати запит до бази даних у правильному форматі.
Data Governance. Це політика управління даними усередині компанії: з вибудовуванням коректних патернів, з правильними документами, регуляторними принципами та сервісами. І головна мета всього цього — допомогти розробникам працювати з даними та доносити їхню цінність. При цьому команда Data Platform залишається як перевіряюча і може або відхилити запит Merge Request, або допомогти розробникам підготувати його. Але не робити це за них: це призведе до хаосу, ті ж «потяги» сповільняться.
Регулятивна функція Data Governance полягає в тому, що у всіх команд є нормативні документи у вигляді сценаріїв, які говорять, що і як робити: візьми бізнес-цінність → зрозумій її суть → оформи її в SQL-запит → подай заявку → захисти свою заявку → викочуй у прод.
Data Management. Це процес управління даними. Максимально конкретний, наприклад: коли береш SQL-запит, використовуй, будь ласка, такі ключові слова, а такі не використовуй. Головна мета – розробити документи та інструменти, які допоможуть розробникам не просто віддавати коректні дані, а транслювати цінність. Адже зрештою потрібно віддати Data-команді не просто дані, а готову інформацію, з якої вони можуть отримати знання чи мудрість. Піраміда даних така:
- Дані – це основа, фундамент.
- Інформація – це очищені дані, які можна проаналізувати.
- Знання : як діяти на основі алгоритмів Data Science, яким чином передбачати тренди, запобігати аномалії та помилкам.
- Мудрість — це вже не просто аналітика, це така собі стратегія прийняття рішення.
Ми в Quadcode дотримуємося data-driven підходу . Це означає, що ми не просто потік некерованих даних, які «носяться» від одного мікросервісу до іншого. Ми можемо будь-якої миті перетворити, структурувати, збагатити дані. Це і є data-driven підхід — коли ми керуємо даними не хаотично, а з розумінням того, що це за дані, звідки вони прийшли до нас, хто за них відповідальний, яка у них якість, хто кінцевий споживач, яку цінність вони нам несуть.
Який висновок можемо зробити з цього? Все залежить від процесів та регламентів, які виставляє Data Platform. Адже вона — фінальна точка ухвалення рішення про те, що ми викочуємо щось у прод. Всі підходи та регламенти, які я описав вище, покликані допомогти розробникам та Data-командам. Варто пам’ятати і про прибуток для самих розробників: вони прокачують технічні скіли (вивчають Data Engineering) і більше поринають у робочий процес: розуміють, яку цінність несуть їхні фічі.
Підсумовуючи
Незважаючи на те, що в компаніях є різні Data-ролі, вони все одно тісно переплітаються: скажімо, Data Engineer потрібні навички Data Analyst — щоб самостійно зрозуміти, наприклад, що дані від команди некоректні, потрібно їх скоригувати.
Звісно, на ринку є й «єдинороги» — фахівці, які вміють все й одразу. Вони бувають незамінні в стартапах та компаніях, де на перше місце виходить швидкість постачання. Сам я більше за поділ, хоча до професії прийшов саме в той час, коли все виконувала одна людина (DBA). Є кілька причин, чому я думаю саме так:
- Зараз стільки технік, фреймворків, мов програмування та іншого, що навіть самому «багатофункціональному єдинорогу» складно за ними наздогнати.
- Не розмивається зона відповідальності, можна притягнути найвідповіднішого виконавця для конкретного завдання.
- Фахівці більше залучені до конкретних процесів і більше розуміють цінність своєї роботи.
Якщо ви тільки замислюєтеся про професію у сфері Data, наполегливо навчайтеся та розвивайтеся. Це дуже цікаво і надзвичайно затребувано!
🚀Долучайтесь до нашої спільноти Telegram:
🚀Долучайтесь до нашої спільноти FaceBook:
🚀Долучайтесь до нашої спільноти Twiter X: