
У світі аналізу даних ми часто використовуємо потужні інструменти, такі як Power BI, не до кінця розуміючи складні механізми, що працюють «під поверхнею». Ця прогалина в знаннях не є лише академічною — розуміння внутрішньої роботи цих інструментів відкриває значні можливості для оптимізації. Коли ми розуміємо, як Power BI обробляє наші дані на архітектурному рівні, ми можемо розробляти рішення, які працюють разом з його базовими механізмами, а не проти них.
Ця стаття є частиною серії «Глибока інженерія» , де ми розкриваємо складність сучасних інструментів для роботи з даними, щоб розкрити їхні основні механізми. Сьогодні ми дослідимо складну екосистему механізмів, що працюють під капотом Power BI — від початкового вилучення та перетворення даних до остаточного аналізу та візуалізації. Розуміючи, як ці різні механізми взаємодіють, ви отримаєте інформацію, яка може значно покращити ваші впровадження Power BI, зробивши їх ефективнішими, продуктивнішими та масштабованішими.
🎖️ Стаття отримала нагороду як обов’язкова до прочитання спільнотою
Power BI Masterclass
Табличний механізм Analysis Services: Фонд
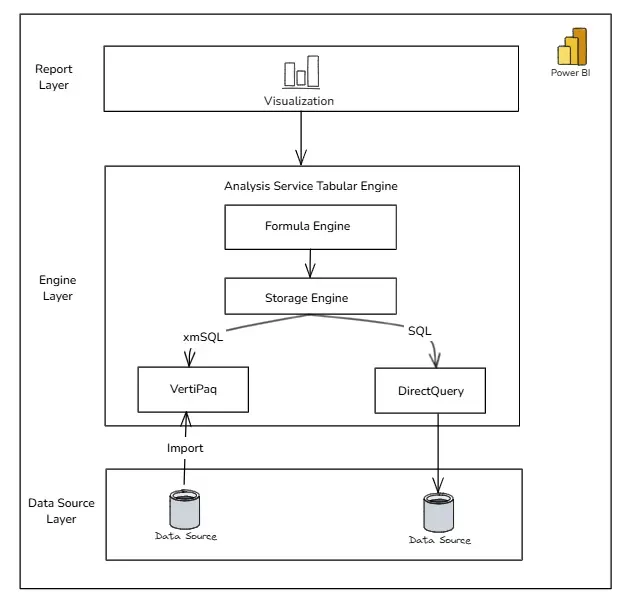
Під час запуску Power BI Desktop створюється локальний екземпляр Analysis Services Tabular Engine. Це основний механізм обробки, який забезпечує всі ваші операції з даними. Щоразу, коли ви відтворюєте візуальний елемент у звіті Power BI, за лаштунками виконується запит DAX до цього Analysis Services Tabular Engine.
Після публікації звіту в службі Power BI екземпляр служб Azure Analysis Services бере на себе його роботу, виконуючи ті самі функції механізму, але в хмарному середовищі. Така архітектура забезпечує стабільну продуктивність незалежно від того, чи працюєте ви локально, чи в хмарі.
Двигун Mashup: потужний інструмент для підготовки даних
Перш ніж дані потраплять до табличного механізму Analysis Services, вони зазвичай проходять через Mashup Engine. Це механізм, який забезпечує роботу як Power Query в Power BI Desktop, так і потоків даних у службі Power BI.
Двигун Mashup (також відомий як M Engine) відповідає за:
- Підключення до різних джерел даних
- Застосування перетворень, написаних мовою M (мова, на якій базується Power Query)
- Очищення та зміна структури даних
- Об’єднання та додавання запитів
- Обробка перетворень типів даних
Коли ви працюєте в редакторі Power Query у Power BI Desktop, ви взаємодієте з Mashup Engine. Кожен крок, який ви створюєте в інтерфейсі користувача, генерує M-код, який виконує механізм. Аналогічно, коли потоки даних запускаються в Power BI Service, вони виконують M-код через хмарну версію Mashup Engine.
Mashup Engine працює окремо від Analysis Services Engine, створюючи чітке розмежування між підготовкою даних (ETL) та моделюванням/аналізом даних. Таке розділення забезпечує більшу гнучкість та оптимізацію продуктивності на кожному етапі пайплайну даних. Після завершення роботи Mashup Engine передає перетворені дані до Analysis Services Tabular Engine для моделювання та аналізу.
Модель з двома механізмами: Formula Engine та Storage Engine
Табличний механізм Analysis Services Tabular Engine працює з використанням двох основних компонентів, що працюють разом: Formula Engine та Storage Engine. Двигун формул (FE): Логічний процесор – Formula Engine (FE): Логічний процесор. Розуміння їхнього взаємозв’язку є ключовим для оптимізації продуктивності Power BI.
Двигун формул (FE): Логічний процесор
Formula Engine відповідає за виконання запитів DAX та обробку всіх вимог до логічної обробки. Його основні функції включають:
- Розбір та перевірка виразів DAX
- Виконання математичних розрахунків
- Виконання об’єднань та додавань таблиць
- Керування логічними операціями та перетвореннями даних
- Застосування фільтрів до наборів даних
Критичною характеристикою Formula Engine є те, що він працює як однопотоковий механізм. Це означає, що він обробляє інструкції послідовно, виконуючи одну операцію за іншою без паралелізації. Це може стати вузьким місцем продуктивності для складних обчислень, особливо коли їх не можна делегувати Storage Engine.
Storage Engine (SE): засіб отримання даних
Коли Formula Engine потрібні дані для виконання обчислень, він надсилає запити до Storage Engine. Основним обов’язком Storage Engine є ефективне отримання даних.
На відміну від Formula Engine, Storage Engine є багатопотоковим. Після отримання інструкцій від FE він може виконувати кілька компонентів своїх запитів одночасно, що значно покращує продуктивність операцій пошуку даних.
Поведінка Storage Engine залежить від режиму зберігання, налаштованого для вашої моделі Power BI:
Режим пам’яті (імпорт)
Коли дані імпортуються в Power BI (стандартний і найпоширеніший сценарій), Storage Engine надсилає запит xmSQL (внутрішня мова запитів) до VertiPaq. VertiPaq — це високооптимізована технологія стовпцевої бази даних у пам’яті, яка стискає дані та забезпечує надзвичайно швидке їх отримання. У планах виконання запитів ці операції відображаються як кроки «Кешування», що вказує на те, що дані витягуються з кешу в пам’яті.
Режим DirectQuery
Під час використання DirectQuery, Storage Engine перетворює свої запити на нативні SQL-запити та надсилає їх безпосередньо до вихідної системи бази даних. Це дозволяє Power BI працювати з даними, які залишаються у вихідній системі, без їх імпорту. Продуктивність у цьому режимі значною мірою залежить від можливостей вихідної системи та мережевого з’єднання між Power BI та джерелом даних.
Повний процес потоку даних
Розуміння того, як усі ці механізми працюють разом, допомагає пояснити типовий процес у рішенні Power BI:
- Збір та перетворення даних : Mashup Engine підключається до джерел даних та застосовує перетворення Power Query.
- Завантаження даних : Трансформовані дані завантажуються в механізм VertiPaq (для режиму імпорту) або зберігається інформація про підключення (для DirectQuery).
- Ініціалізація запиту : користувач взаємодіє з візуальним елементом, що генерує запит DAX.
- Обробка запитів : Formula Engine отримує та аналізує цей запит
- Запит на отримання даних : FE визначає, які дані йому потрібні, та надсилає запити до Storage Engine.
- Отримання даних : SE отримує необхідні дані (або з VertiPaq, або з вихідної системи)
- Остаточний розрахунок : FE застосовує будь-які розрахунки, які не можна було делегувати SE.
- Відображення результатів : результати повертаються до візуального елемента для відображення.
Ця багатопроцесорна архітектура пояснює, чому деякі операції в Power BI виконуються блискавично швидко, тоді як інші можуть тривати довше. Операції, які можна передати багатопотоковому механізму сховища та ефективно обробити VertiPaq, як правило, працюють надзвичайно добре. І навпаки, складні обчислення, які мають повністю оброблятися однопотоковим механізмом формул, можуть мати обмеження продуктивності.
Механізм VertiPaq: секретна зброя Power BI
Механізм VertiPaq заслуговує на особливу увагу, оскільки саме він відповідає за значну частину вражаючої продуктивності Power BI під час роботи з імпортованими даними. Цей вбудований у пам’ять стовпцевий механізм баз даних:
- Значно стискає дані (часто досягаючи коефіцієнта стиснення 10:1)
- Організовує дані у стовпцях, а не в рядках, оптимізуючи для аналітичних запитів
- Підтримує словники та зв’язки для швидкого пошуку
- Використовує складні алгоритми для обробки сканування та агрегації даних
Дизайн VertiPaq робить його особливо пристосованим для типів операцій, поширених у бізнес-аналітиці: фільтрації, групування та агрегації великих наборів даних.
Екосистема механізмів у Power BI Service
Під час роботи з Power BI Service екосистема механізмів розширюється:
- Dataflow Mashup Engine : виконує M-перетворення у хмарі
- Premium Capacity: забезпечує виділені ресурси для різних механізмів
- Служби аналізу Azure : Розміщує функціональність механізму формул та механізму сховища.
- Power Query Online : Надає браузерний інтерфейс до Mashup Engine
Ця розподілена архітектура дозволяє Power BI ефективно масштабуватися в корпоративних сценаріях, зберігаючи при цьому ту саму фундаментальну структуру механізму.
Висновок
Архітектура Power BI використовує спеціалізовані механізми, розроблені спеціально для різних етапів аналітичного робочого процесу. Розуміння взаємозв’язку між Mashup Engine, Formula Engine, Storage Engine та VertiPaq допомагає пояснити характеристики продуктивності Power BI та надає інформацію для оптимізації.
Для найкращої продуктивності:
- Розробляйте ефективні перетворення Power Query для оптимізації роботи Mashup Engine
- Використовуйте показники та розрахунки, які можна делегувати Storage Engine, коли це можливо.
- Зверніть увагу на операції, які вимагатимуть значної обробки Formula Engine.
- Виберіть відповідний режим зберігання даних, виходячи з ваших конкретних вимог та обсягів даних
Ці знання внутрішніх механізмів Power BI дозволяють розробникам та аналітикам створювати ефективніші процеси підготовки даних, оптимізовані моделі даних та формувати звіти, що швидше дають аналітичну інформацію.
Дякую за прочитання!
Будь ласка, не соромтеся поставити 50 плескань 👏, якщо ця стаття була корисною, залиште коментар або поділіться нею з іншими.
👉 Підпишіться на мене або ✉️ , щоб отримувати всі мої статті про Power BI!
Ви можете знайти мене на LinkedIn .
Не забудьте підписатися на
та приєднуйтесь до нашої спільноти Power BI:
Класифікація статей майстер-класу Power BI
Обов’язково прочитайте : Так
Рівень: Початківець, Середній, Експерт
Категорія: Посібник, Модель даних
Теги: Посібник, Модель даних
ОРИГІНАЛ СТАТТІ:Understanding Power BI Engine Architecture: A Deep Dive
АВТОР СТАТІ:Avishek Ghosh (AV_DEVS)
🚀Долучайтесь до нашої спільноти Telegram:
🚀Долучайтесь до нашої спільноти FaceBook:
🚀Долучайтесь до нашої спільноти Twiter X: