Тепер можна створювати snapshots, щоб відстежувати історію змін, і analyses, щоб досліджувати дані.
Список статей
- Спробуймо dbt. Частина 1 — пролог
- Спробуймо dbt. Частина 2 — перший запуск
- Спробуймо dbt. Частина 3 — seed і source
- Спробуймо dbt. Частина 4 — матеріалізація моделей
- Спробуймо dbt. Частина 5 — від Jinja до макросів і хуків
- Спробуймо dbt. Частина 6 — знімки та аналізи
- Спробуймо dbt. Частина 7 — тести
- Спробуймо dbt. Частина 8 — DAG і документація
- Спробуймо dbt. Частина 9 — змінні
- Спробуймо dbt. Частина 10 — пакети
- Спробуймо dbt. Частина 11 — SQLFluff і Pre-Commit
Snapshots
Snapshots — це ніби «заморожування» даних у певний момент часу. Вони корисні, щоб чітко показати, якими були дані на певний момент, як вони змінювалися з часом, або просто як резервна копія.
Для цього є кілька методів та інструментів. Наприклад, BigQuery дозволяє:
- отримати дані на певний момент часу за допомогою
SYSTEM_TIME[1], ось так:SELECT * FROM `project.dataset.table` FOR SYSTEM_TIME AS OF "2025-01-01"
SELECT *
  FROM `project.dataset.table`
FOR SYSTEM_TIME AS OF "2025-01-01"- створити знімки таблиць BigQuery (table snapshots)[2] — нову таблицю, яка зберігає дані цільової таблиці на конкретний
SYSTEM_TIME; - або навіть відновити видалені таблиці BigQuery за допомогою time travel[3], ось так:
epoch=$(date -d '2025-01-01 00:00:00' +%s000)
  bq --project_id=my_project cp dataset.table@$epoch dataset.restored_table
epoch=$(date -d '2025-01-01 00:00:00' +%s000)
  bq --project_id=my_project cp dataset.table@$epoch dataset.restored_table
Тепер же ми використаємо dbt snapshots, щоб створити нову таблицю за принципом SCD типу 2[4].
Підготовка джерела даних
Припустімо, у нас є таке визначення джерела з даними про зарплати:
version: 2

sources:
  - name: salary
    schema: raw
    tables:
      - name: salary
        columns:
          - name: id
          - name: name
          - name: salary
- name: updated_atА дані на початку та після змін виглядають так:
Початкові дані
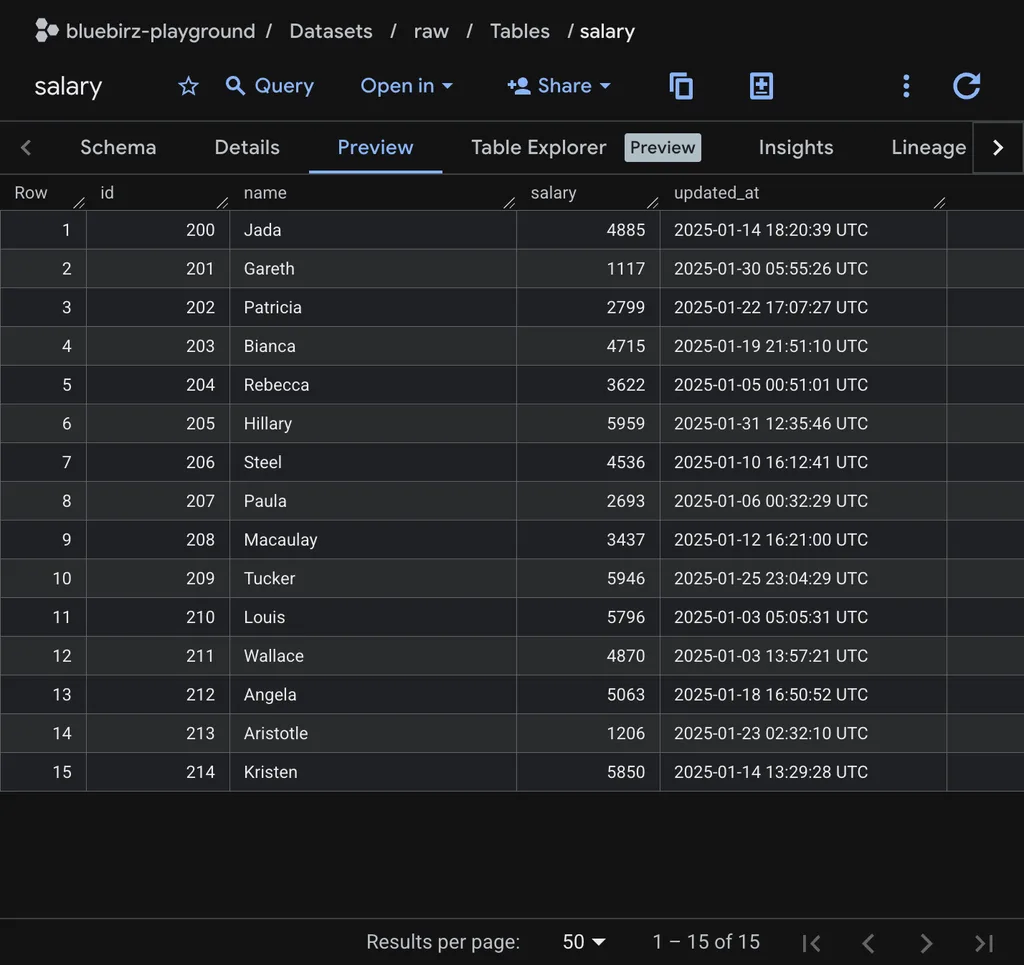
У нас є 15 рядків із зарплатами людей.
Змінені дані
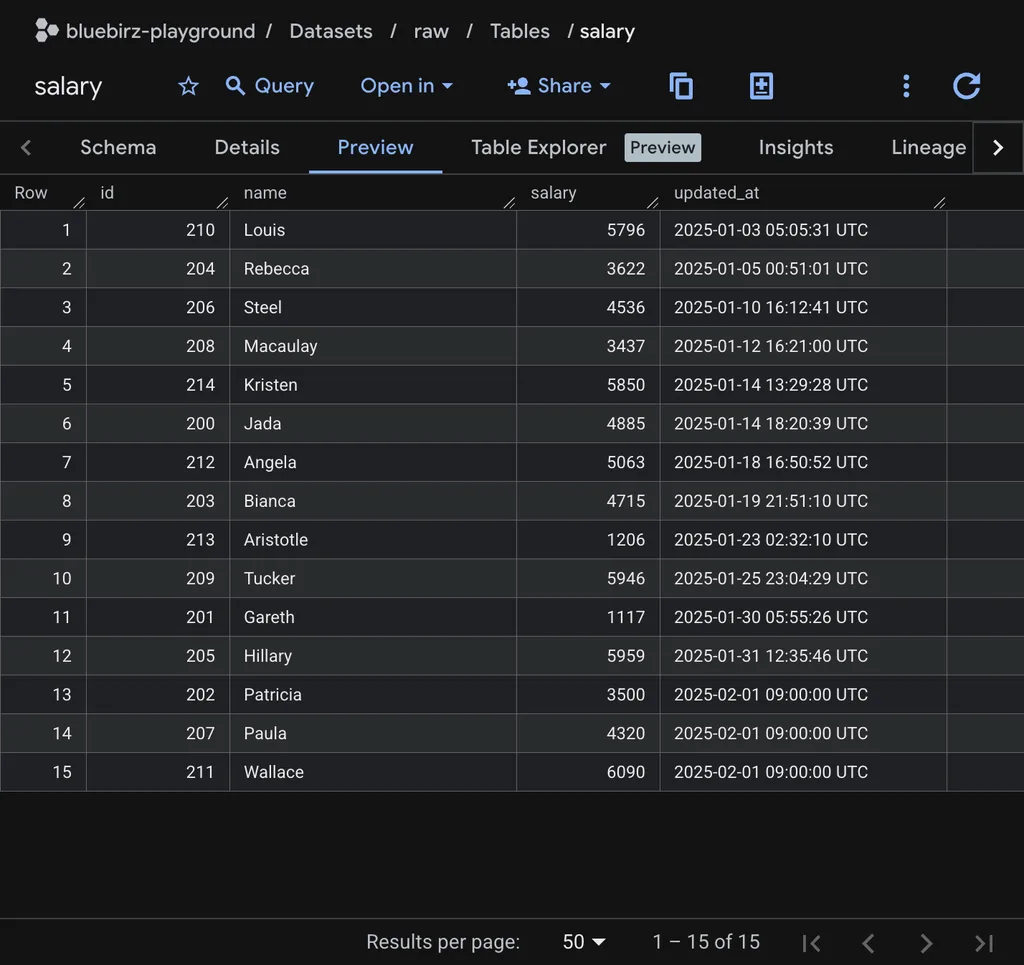
Зарплату оновлено в рядках 13-15 з тією самою датою updated_at.
Конфігурація
Щоб створювати snapshots[5] у dbt, можна визначити стратегію одним із двох способів.
strategy='timestamp'Ця стратегія чудово підходить і рекомендована для таблиць, які мають стовпець із часовою позначкою оновлення або подібний. За цією позначкою dbt порівнює рядки й визначає, які з них було оновлено.strategy='check'Ця стратегія перевіряє окремі стовпці (або всі) і знаходить рядки, які змінилися. Вона корисна, коли поля з часовою позначкою оновлення немає, але ціною обчислень по кількох стовпцях для пошуку відмінностей.
Далі можна переходити до написання конфігурації:
- для dbt версії 1.8 і раніше використовується застаріла (legacy)[6] конфігурація в блоках Jinja (у цьому дописі вона не розглядається);
- для dbt версії 1.9 і новіших ми пишемо YAML-файли такої структури.
snapshots:
  - name: <snapshot_name>
    relation: <source() or ref()>
    description: <description>
    config:
      strategy: <timestamp|check>
      unique_key: <unique_key_field>
      check_cols: <'all'|[column_names] when strategy='check'>
updated_at: <updated timestamp field when strategy='timestamp'>Запуск
Щоб побудувати snapshots, виконуємо команду нижче.
dbt snapshotВиконання зі стратегією timestamp
Спершу спробуймо побудувати snapshots зі стратегією timestamp.
snapshots-salary.yml
snapshots:
  - name: snapshot-salary-timestamp
    relation: source('salary', 'salary')
    config:
      target_schema: snapshots
      alias: salary_ts
      strategy: timestamp
      unique_key: id
updated_at: updated_atМи використовуємо стратегію timestamp для джерела salary, де id — це unique_key, а updated_at — поле з часовою позначкою оновлення.
Перший запуск
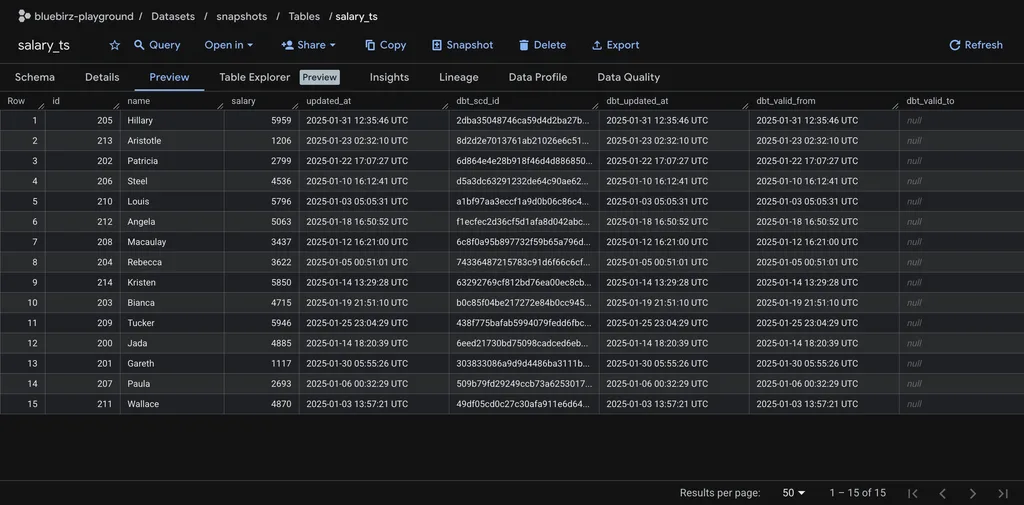
Під час першого запуску dbt snapshot ми бачимо нову таблицю, схожу на джерело, але з додатковими полями:
dbt_scd_id— внутрішній унікальний ключ dbt;dbt_updated_atпоходить від початкового поляupdated_atі використовується dbt внутрішньо;dbt_valid_fromтакож походить відupdated_atі означає: «цей рядок чинний із цього моменту»;dbt_valid_toмає значенняnull, що означає: «цей рядок досі чинний, тому тутnull».
Запуск після зміни джерела
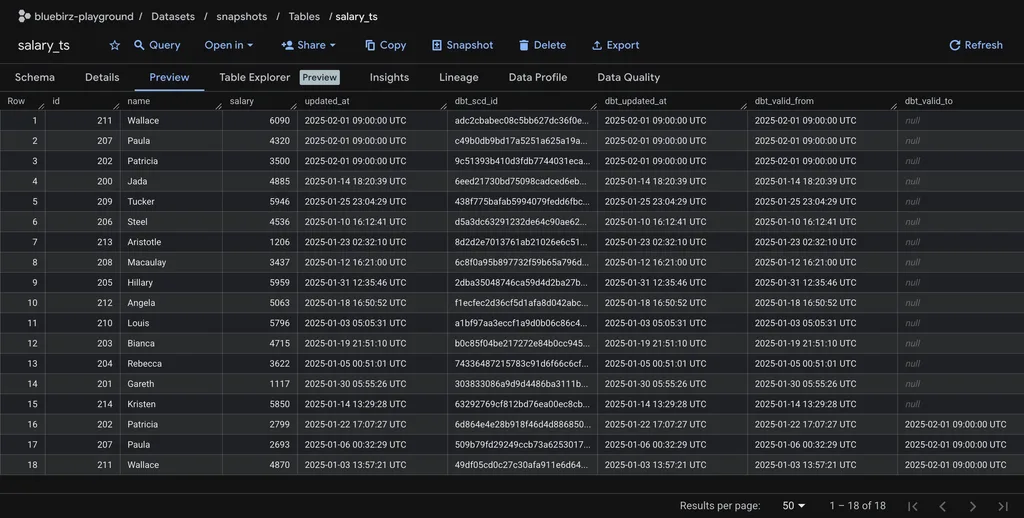
Бачимо, що в останніх трьох рядках dbt_valid_to має значення. Це означає, що ці рядки втратили чинність. Тепер погляньмо на перші три рядки, які:
- мають ті самі
id, у яких змінилася зарплата;- мають
dbt_valid_from, що відображає значенняdbt_updated_atтаupdated_at; - мають
dbt_valid_toзі значеннямnull, тобто вони чинні.
- мають
Виконання зі стратегією check
Тепер спробуймо стратегію check для snapshots.
snapshots-salary.yml
snapshots:
  - name: snapshot-salary-check
    relation: source('salary', 'salary')
    config:
      target_schema: snapshots
      alias: salary_chk
      strategy: check
      unique_key: id
check_cols: allСтратегія check, як і timestamp, потребує unique_key, але ще й check_cols: це або all, щоб перевіряти всі стовпці, або список стовпців, якщо перевіряти всі не потрібно.
Перший запуск
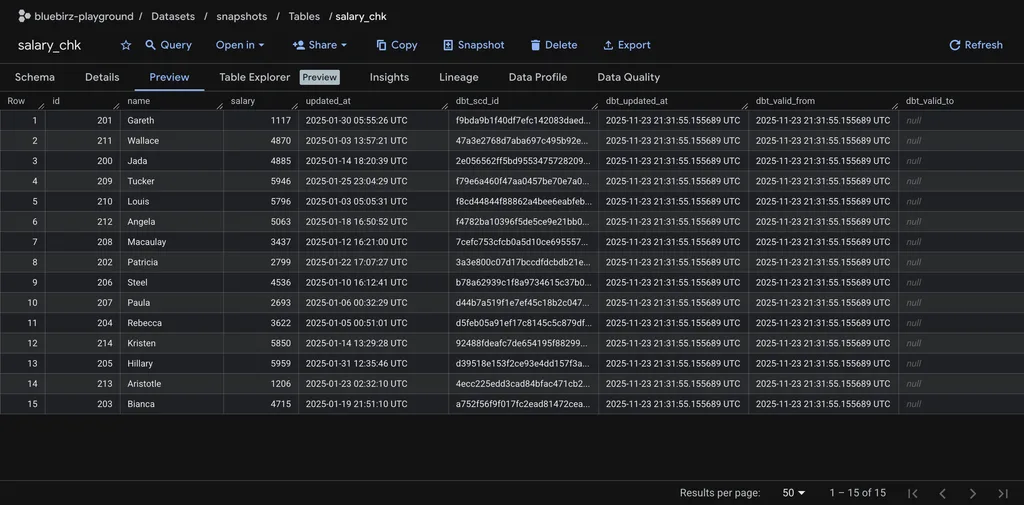
Під час першого запуску цього snapshot ми бачимо додаткові поля, подібні до стратегії timestamp, окрім такого:
dbt_updated_at— це час виконання, бо за стратегіїcheckdbt вважає, що часової позначки оновлення немає;dbt_valid_from— теж час виконання.
Запуск після зміни джерела
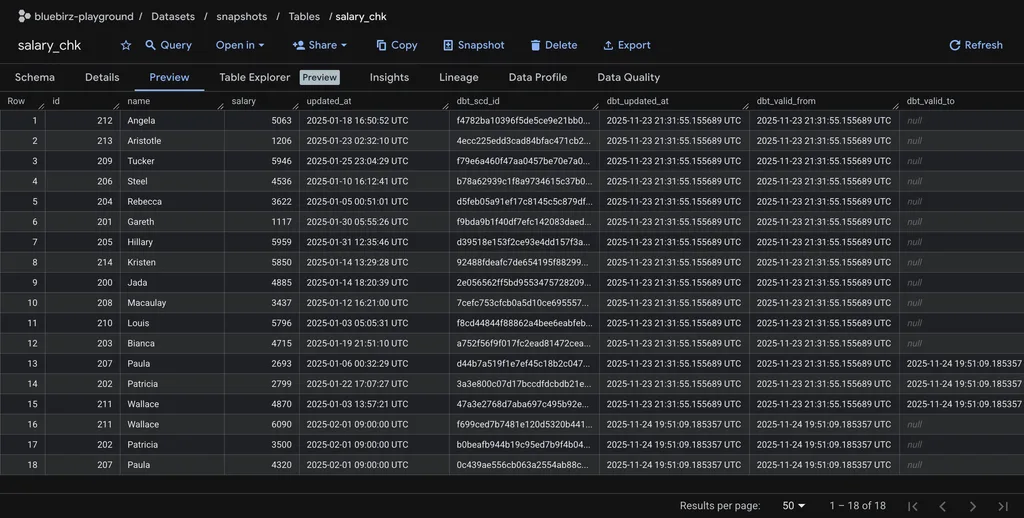
Поведінка така сама, як і зі стратегією timestamp, але dbt_updated_at, dbt_valid_from і dbt_valid_to — це час виконання.
Analyses
Analyses[7] — це скрипти для разових (ad-hoc) запитів. Наприклад, коли потрібно знайти дані станом на певну дату й час або дослідити якісь закономірності. Ми не хочемо робити з них моделі, бо нам просто потрібно щось перевірити, тож створюємо analyses.
Розробка analyses зводиться до створення файлу з інструкцією в каталозі analyses, наприклад такого.
select *
from {{ source("salary", "salary") }} s
where s.salary >= 5000Потім виконуємо dbt compile, щоб побачити результат.
Compiled node 'verify-data' is:
select *
from `bluebirz-playground`.`raw`.`salary` s
where s.salary >= 5000Після цього скомпільований запит можна скопіювати й виконати в базі даних.
У BigQuery можна виконати bq query безпосередньо зі скомпільованого файлу, що лежить у target/compiled/, ось так.
$ bq query --use_legacy_sql=false \
  "$(cat target/compiled/<dbt_project>/analyses/verify-data.sql)"
+-----+---------+--------+---------------------+
| id  |  name   | salary |     updated_at      |
+-----+---------+--------+---------------------+
| 210 | Louis   |   5796 | 2025-01-03 05:05:31 |
| 214 | Kristen |   5850 | 2025-01-14 13:29:28 |
| 212 | Angela  |   5063 | 2025-01-18 16:50:52 |
| 209 | Tucker  |   5946 | 2025-01-25 23:04:29 |
| 205 | Hillary |   5959 | 2025-01-31 12:35:46 |
| 211 | Wallace |   6090 | 2025-02-01 09:00:00 |
+-----+---------+--------+---------------------+Підсумок
- Snapshots
- використовуються для відстеження історії змін;
- у YAML-файлах визначаються для dbt версії 1.9 і новіших, для старіших версій пишемо блоки Jinja;
- рекомендовано стратегію
timestamp, коли достатньо перевіряти лише полеupdated_at, абоcheck, якщо в таблиці немає поляupdated_at; - у
relationвказуємо цільову таблицю, а вunique_key— її унікальний ключ, на основі яких будуватиметься snapshot; dbt snapshotбудує таблиці snapshots.
- Analyses
- використовуються для разових запитів, як-от дослідження даних чи одноразова аналітика;
- SQL-файл створюється в каталозі
analyses; - після
dbt compileскомпільовані запити лежать уtarget/compiled/<dbt_project>/analyses/, звідки їх можна виконати в базі даних.
Джерела
- Доступ до історичних даних | BigQuery | Документація Google Cloud
- Вступ до знімків таблиць | BigQuery | Документація Google Cloud
- Зберігання даних із time travel і fail-safe | BigQuery | Документація Google Cloud
- SCD типу 2 | Slowly Changing Dimensions
- Властивості snapshot | dbt Developer Hub
- Застарілі конфігурації snapshot | dbt Developer Hub
- Analyses | dbt Developer Hub
ОРИГІНАЛ СТАТТІ: Let’s try: dbt part 6 – snapshots and analyses
АВТОР СТАТТІ: bluebirz
Оригінал опубліковано під ліцензією CC BY 4.0. Цей матеріал є перекладом українською мовою.
Доєднуйтесь до наших спільнот 👇