У попередній частині ми підготували джерела даних, тому тепер можемо перейти до побудови продуктів даних із різними моделями трансформації для вирішення бізнес-задач.
Список статей
- Спробуймо dbt. Частина 1 — пролог
- Спробуймо dbt. Частина 2 — перший запуск
- Спробуймо dbt. Частина 3 — seed і source
- Спробуймо dbt. Частина 4 — матеріалізація моделей
- Спробуймо dbt. Частина 5 — від Jinja до макросів і хуків
- Спробуймо dbt. Частина 6 — знімки та аналізи
- Спробуймо dbt. Частина 7 — тести
- Спробуймо dbt. Частина 8 — DAG і документація
- Спробуймо dbt. Частина 9 — змінні
- Спробуймо dbt. Частина 10 — пакети
- Спробуймо dbt. Частина 11 — SQLFluff і Pre-Commit
Моделі dbt
Моделі (models) — це продукти даних, створені для відповідей на реальні бізнес-питання або надання аналітики особам, які приймають рішення.
dbt надає інструменти побудови моделей для зручного керування наборами даних. Важливо розуміти, коли та яку матеріалізацію вибирати, щоб отримати максимальну продуктивність і забезпечити комфортний досвід для користувачів.
Наразі в dbt доступно 5 типів матеріалізації:[1]
- View (Представлення)
- Table (Таблиця)
- Incremental (Інкрементальна)
- Ephemeral (Ефемерна / тимчасова)
- Materialized View (Матеріалізоване представлення)
Налаштування матеріалізації
Вказати тип матеріалізації можна 3 способами:
- У файлі
dbt_project.yml - Усередині макросу
config()у SQL-файлі моделі - У YAML-файлах конфігурації моделей (наприклад,
property.yml)
Структура та приклади конфігурації
file tree
dbt_proj01
├── dbt_project.yml
└── models
    └─── climate
         ├── property.yml
         ├── sources.yml
└── weekly-delhi-climate.sqldbt_project.yml
models:
  dbt_proj01:
    # Символ + означає, що конфігурація застосовується до всіх файлів у директорії
    example:
      +materialized: <materialization type>
    climate:
+materialized: <materialization type>model SQL files
{{-
  config(
    materialized='<materialization type>',
  )
-}}
SELECT
...property.yml
version: 2

models:
  - name: <model name>
    config:
materialized: <materialization type>Тепер ми розглянемо, як застосовувати та створювати модель для кожного типу матеріалізації.
Практичний приклад побудови моделей
Припустимо, у нас є дані про погоду в місті Делі з Kaggle.
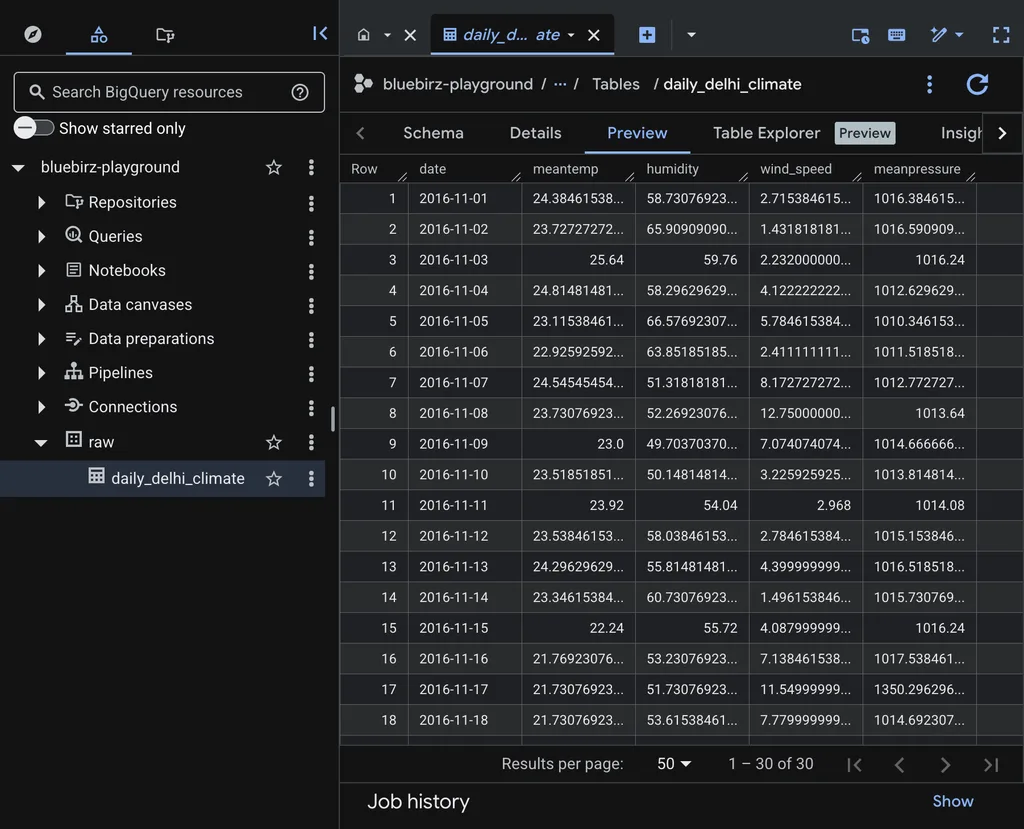
Конфігураційний файл sources.yml виглядає так:
version: 2

sources:
  - name: delhi_climate
    schema: raw
    tables:
      - name: daily_delhi_climate
        columns:
          - name: date
            description: Date of format YYYY-MM-DD
          - name: meantemp
            description: Mean temperature averaged out from multiple 3 hour intervals in a day.
          - name: humidity
            description: Humidity value for the day (units are grams of water vapor per cubic meter volume of air).
          - name: wind_speed
            description: Wind speed measured in kmph.
          - name: meanpressure
description: Pressure reading of weather (measure in atm)Завдання: розрахувати середнє значення для 4 показників у розрізі тижнів (починаючи з неділі).
Календар за цей період наведено нижче:
                            2016
      October               November              December
Su Mo Tu We Th Fr Sa  Su Mo Tu We Th Fr Sa  Su Mo Tu We Th Fr Sa
                   1         1  2  3  4  5               1  2  3
 2  3  4  5  6  7  8   6  7  8  9 10 11 12   4  5  6  7  8  9 10
 9 10 11 12 13 14 15  13 14 15 16 17 18 19  11 12 13 14 15 16 17
16 17 18 19 20 21 22  20 21 22 23 24 25 26  18 19 20 21 22 23 24
23 24 25 26 27 28 29  27 28 29 30           25 26 27 28 29 30 31
30 31Наприклад, тиждень може тривати з неділі, 30 жовтня, по суботу, 5 листопада, наступний тиждень — з неділі, 6 листопада, по суботу, 12 листопада, і так далі.
Перейдімо до створення всіх 5 моделей разом.
Матеріалізація: View (Представлення)
Представлення (view) — це тип матеріалізації моделей dbt за замовчуванням.
Ми розглядаємо представлення, коли хочемо керувати даними за допомогою невеликих трансформацій, таких як вибір (select) певних полів, приведення їх до нижнього регістру та об’єднання (union) з іншими таблицями. Керування доступом (дозволяти чи не дозволяти користувачам виконувати запити) є однією з найбільших переваг представлень.
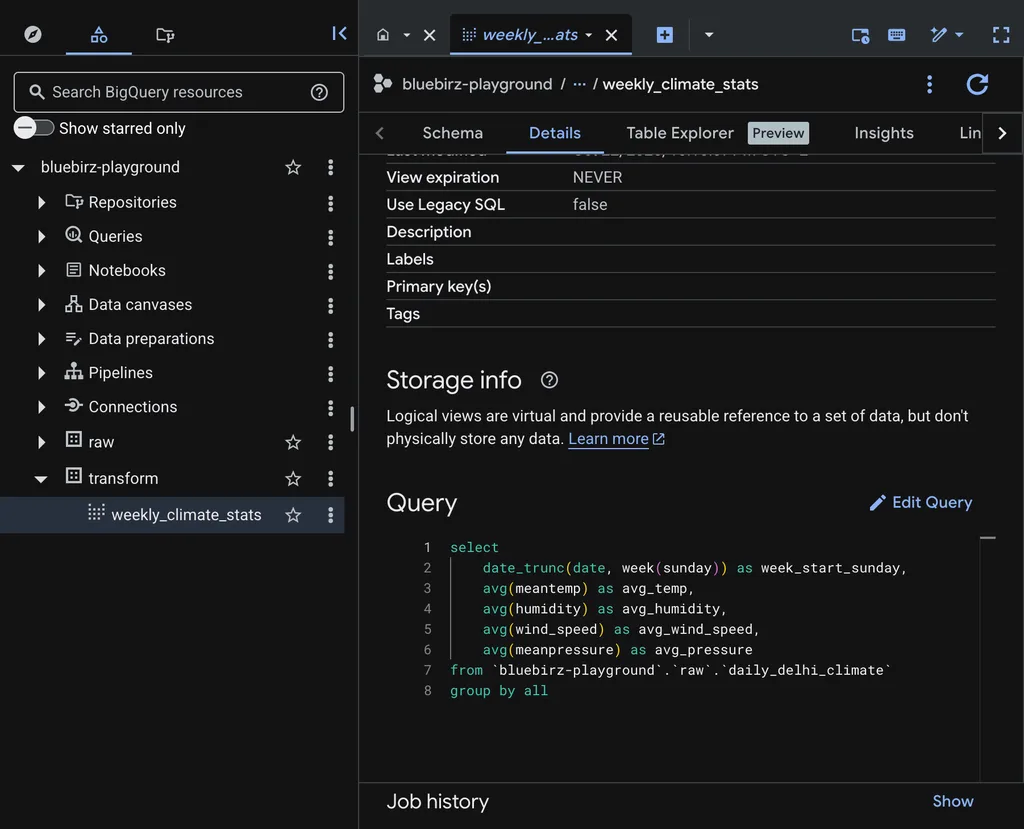
Ми створюємо представлення, вказавши materialized='view' у функції config() або не вказуючи це взагалі, щоб dbt створив представлення за замовчуванням.
model
{{- config(schema="transform", alias="weekly_climate_stats", materialized="view") -}}
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure
from {{ source("delhi_climate", "daily_delhi_climate") }}
group by all
{{ config(materialized='view') }}— вказує тип матеріалізації.date_trunc(date, week(sunday))— повертає дату найближчої неділі для переданої дати.{{ source() }}— посилання на джерело даних ізsources.yml.
result
Матеріалізація: Table (Таблиця)
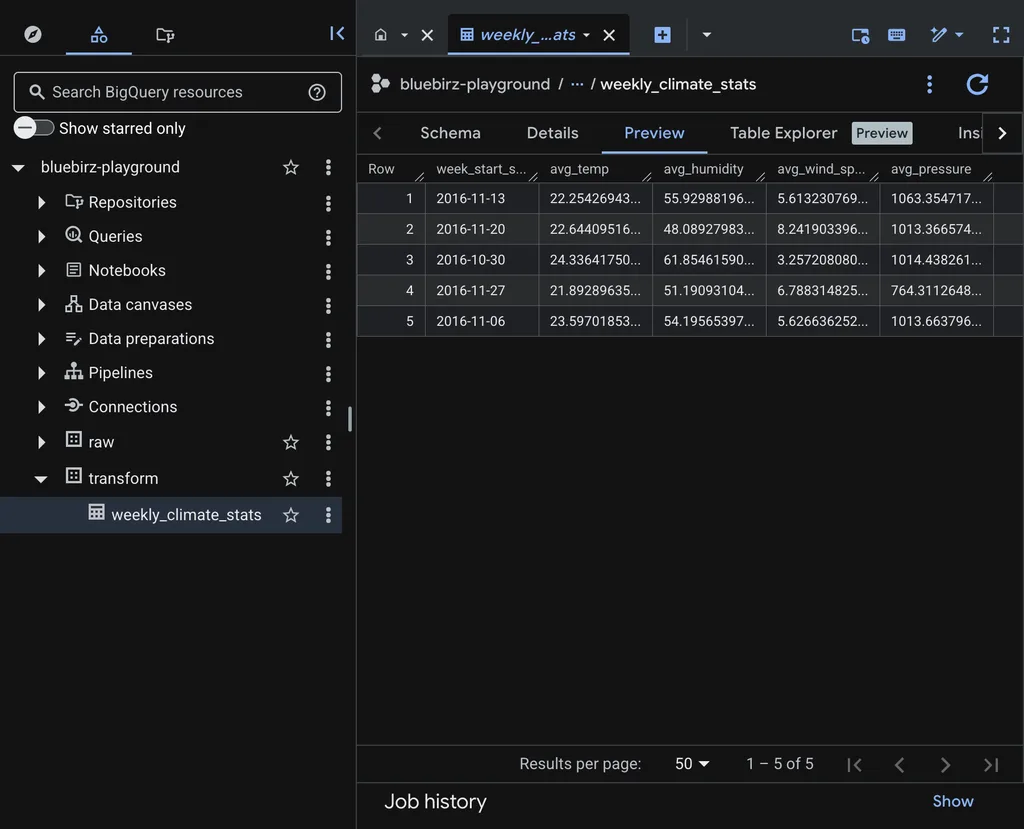
Базовий тип матеріалізації, який зберігає результат у фізичну таблицю.
Використовується для готових моделей даних, аналітичних звітів чи дашбордів, коли запит виконується довго, і користувачам недоцільно чекати розрахунку в режимі реального часу через view.
model
Просто додайте materialized='table', і ця модель стане таблицею.
{{- config(schema="transform", alias="weekly_climate_stats", materialized="table") -}}
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure
from {{ source("delhi_climate", "daily_delhi_climate") }}
group by allresult
Матеріалізація: Incremental (Інкрементальна)
Коли таблиця занадто велика і немає сенсу щоразу повністю оновлювати в ній дані, оптимальним рішенням стане інкрементальна модель (incremental model).
Ми використовуємо інкрементальні моделі, коли таблиця має значний обсяг і повне перезавантаження результатів при кожному запуску є недоцільним — це марна витрата часу та грошей. Такі моделі дозволяють забирати з джерела лише нові або змінені дані (дельту), трансформувати їх і додавати до цільової таблиці. Це ближче до підходу SCD Type 1 (повільно змінювані виміри): нові рядки додаються, а наявні за збігом ключа оновлюються без збереження історії. Щоб зберігати історію змін (SCD Type 2), у dbt використовують snapshots, про які йтиметься в частині 6. Докладніше про SCD можна прочитати в статті на блозі автора оригіналу.
Щоб ефективно працювати з інкрементальними моделями, варто розібратися в інкрементальних стратегіях[2] — таких як append або merge, вибір яких залежить від конкретного адаптера бази даних.
SQL-код моделі:
{{-
    config(
        schema="transform",
        alias="weekly_climate_stats",
        materialized="incremental",
        incremental_strategy="merge",
        unique_key="week_start_sunday",
    )
-}}
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
    current_timestamp() as inserted_at
from {{ source("delhi_climate", "daily_delhi_climate") }}
{% if is_incremental() -%}
    where
        date_trunc(date, week(sunday)) > (select max(week_start_sunday) from {{ this }})
{%- endif %}
group by allmaterialized="incremental"— визначає цю модель як інкрементальну.incremental_strategy="merge"— задає використання операції злиття (merge).unique_key=["<field1>", "<field2>", ...]— призначає унікальні поля, за якими порівнюватимуться значення під час операціїmerge.is_incremental()повертає значенняtrueлише за одночасного виконання таких умов:
- таблиця для цієї моделі вже існує;
- модель налаштована як інкрементальна;
- запуск відбувається без прапорця
--full-refresh.
- таблиця для цієї моделі вже існує;
- Якщо
is_incremental()повертаєfalse, модель буде матеріалізована як звичайна таблиця (table). - Блок
{% if is_incremental() %}...{% endif %}додає вміщений у нього SQL-код до основного запиту лише тоді, колиis_incremental()має значенняtrue. - У наведеній вище моделі активується умова
WHERE, щоб відібрати виключно нові записи. - Умова
where date_trunc(...) > (select max(week_start_sunday) from ...)означає, що вибиратимуться лише ті нові записи, у яких початкова неділя тижня є новішою за останню (максимальну) датуweek_start_sundayу поточній таблиці. {{ this }}використовується для посилання моделі на саму себе.
Перший запуск
source
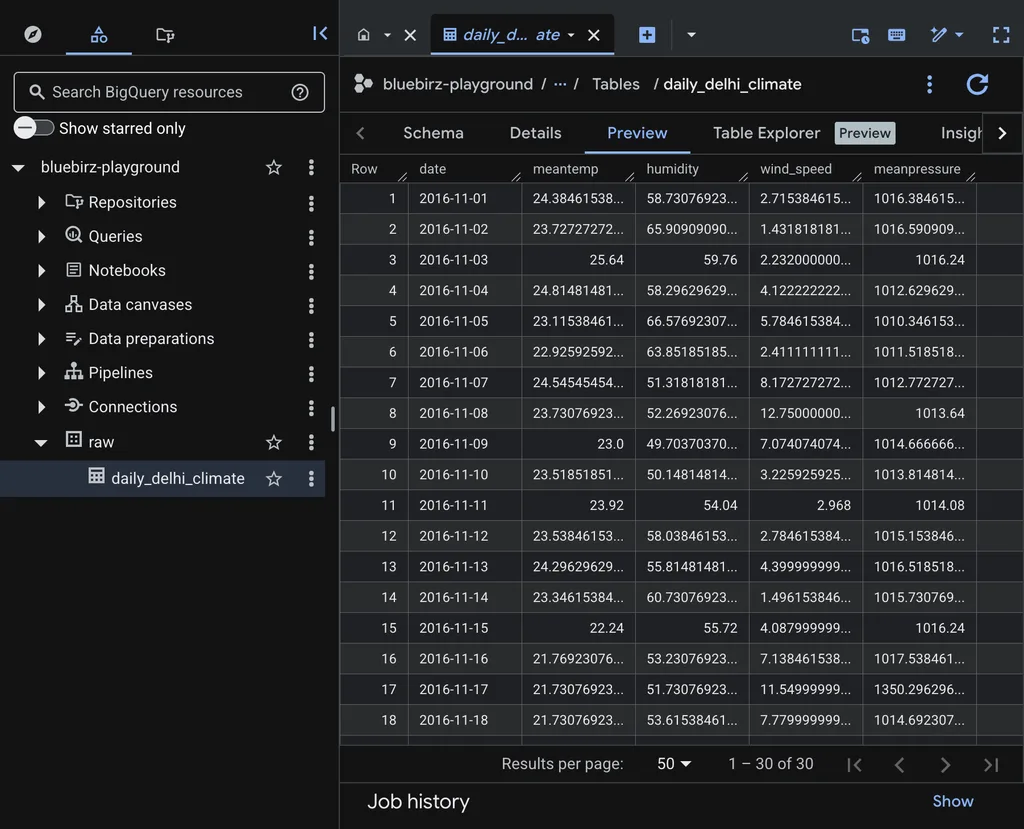
Таблиці transform.weekly_climate_stats для цієї інкрементальної моделі ще не існує, а в джерелі станом на листопад 2016 року налічується 30 записів.
result
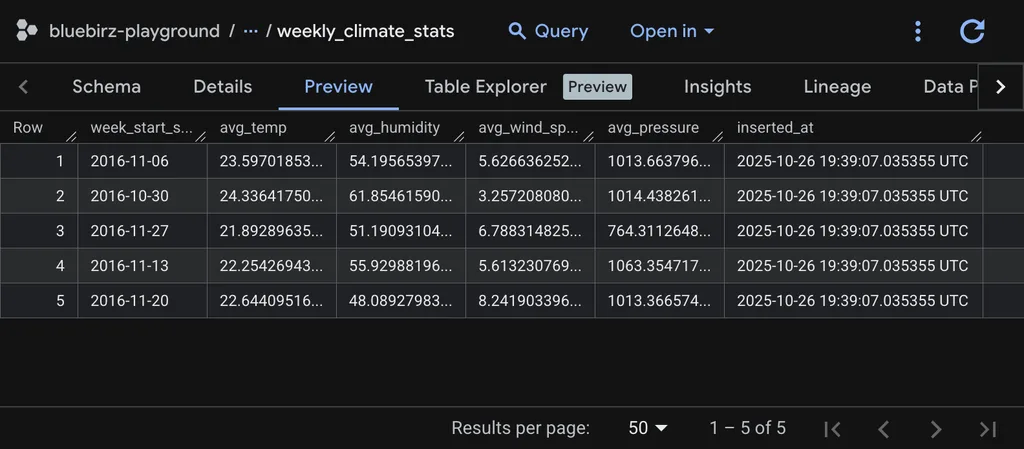
Ми отримали таблицю transform.weekly_climate_stats, яка містить 5 записів.
final query
Модель запускається як нова за допомогою команди create or replace table ....
$ cat target/run/dbt_proj01/models/climate/weekly-delhi-climate.sql

    create or replace table `bluebirz-playground`.`transform`.`weekly_climate_stats`


    OPTIONS()
    as (
      select date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
    current_timestamp() as inserted_at
from `bluebirz-playground`.`raw`.`daily_delhi_climate`

group by all
);Наступний запуск
source
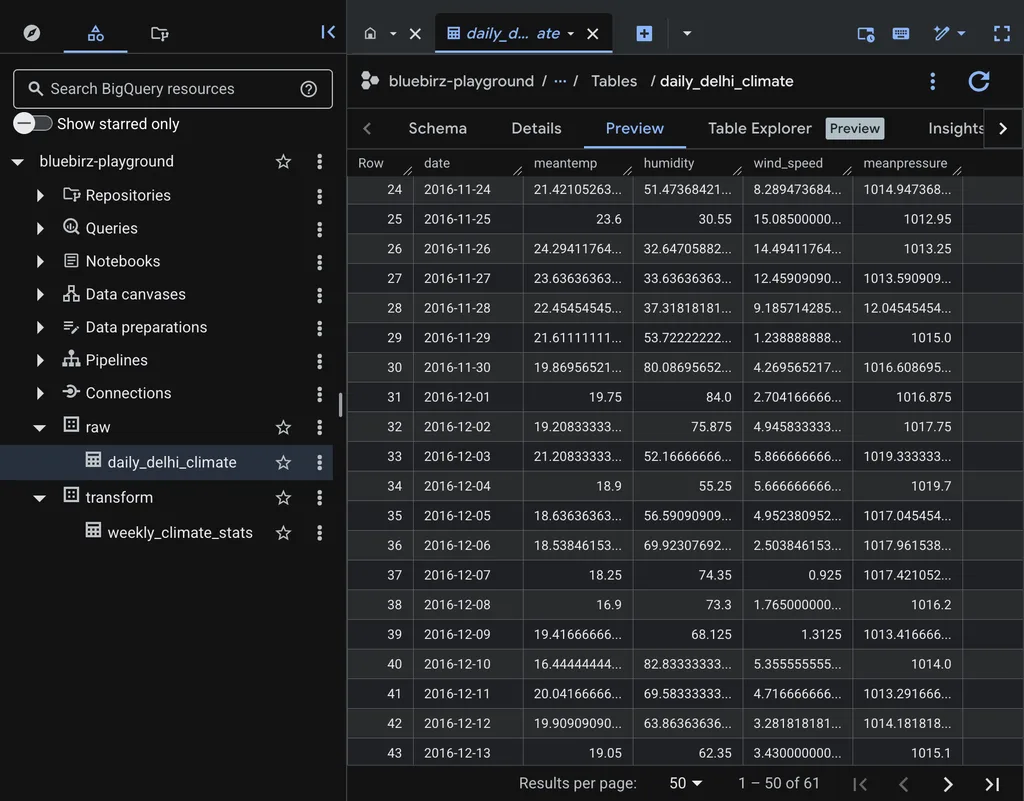
Тепер у нас є інкрементальна модель, а крім того, у вихідній таблиці з’явився ще 31 запис. Це дані за грудень 2016 року.
result
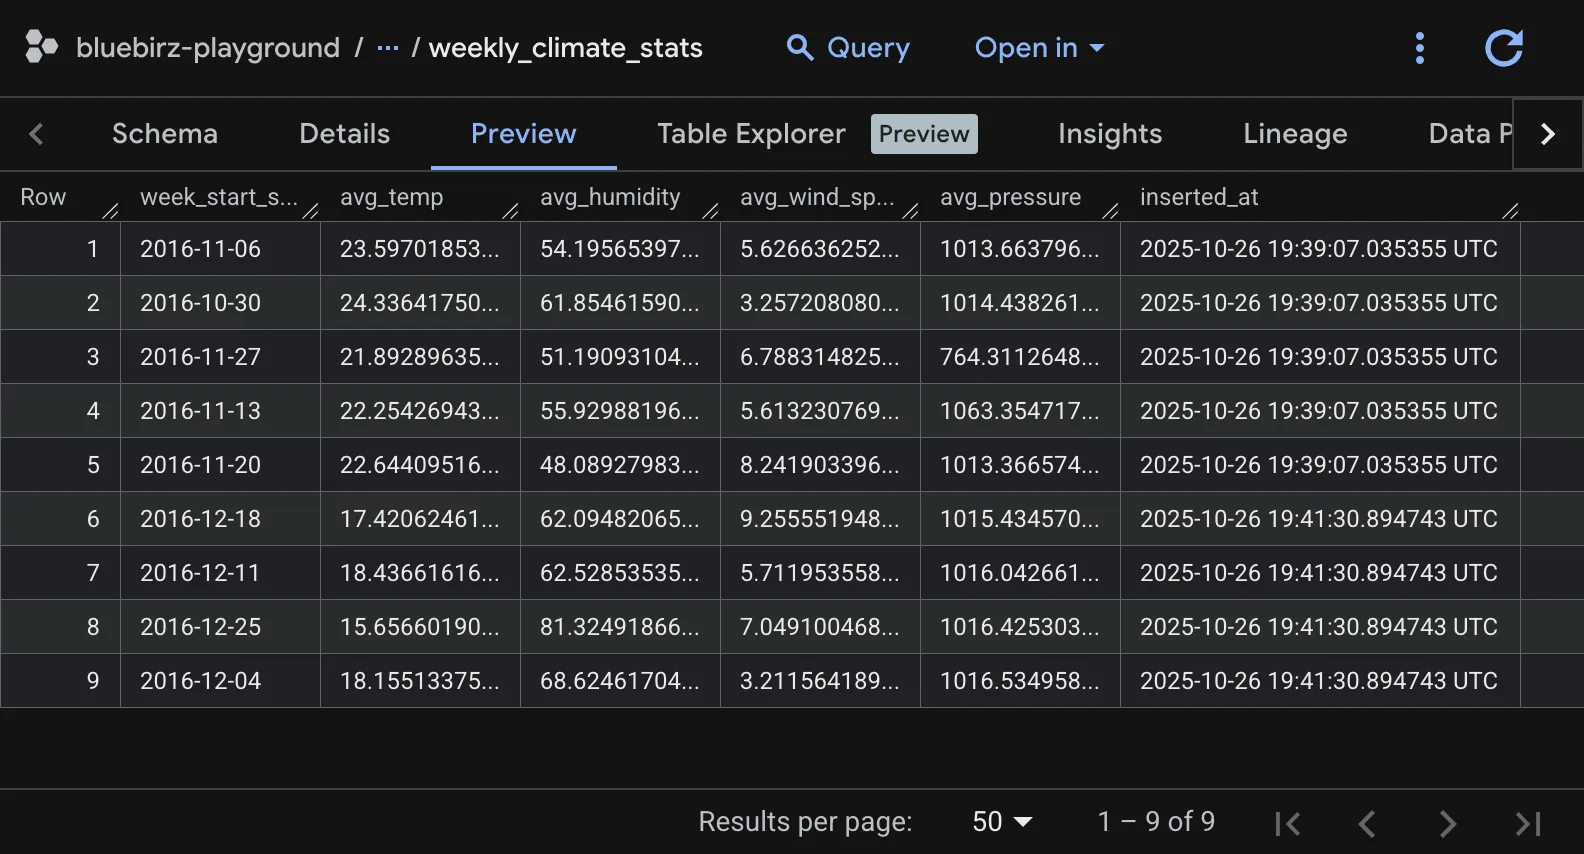
Загалом рядків стало 9. Нові рядки, у яких week_start_sunday припадає на грудень 2016 року, мають інше значення inserted_at.
final query
Цього разу модель використовує операцію merge і має умову where для вибору нових записів (рядки 12-13). Якщо запис збігається, він оновлюється, а якщо ні, то вставляється.
$ cat target/run/dbt_proj01/models/climate/weekly-delhi-climate.sql
merge into `bluebirz-playground`.`transform`.`weekly_climate_stats` as DBT_INTERNAL_DEST
using (select date_trunc(date, week(sunday)) as week_start_sunday,
avg(meantemp) as avg_temp,
avg(humidity) as avg_humidity,
avg(wind_speed) as avg_wind_speed,
avg(meanpressure) as avg_pressure,
current_timestamp() as inserted_at
from `bluebirz-playground`.`raw`.`daily_delhi_climate`
where
date_trunc(date, week(sunday)) > (select max(week_start_sunday) from `bluebirz-playground`.`transform`.`weekly_climate_stats`)
group by all
) as DBT_INTERNAL_SOURCE
on ((DBT_INTERNAL_SOURCE.week_start_sunday = DBT_INTERNAL_DEST.week_start_sunday))
when matched then update set
`week_start_sunday` = DBT_INTERNAL_SOURCE.`week_start_sunday`,`avg_temp` = DBT_INTERNAL_SOURCE.`avg_temp`,`avg_humidity` = DBT_INTERNAL_SOURCE.`avg_
humidity`,`avg_wind_speed` = DBT_INTERNAL_SOURCE.`avg_wind_speed`,`avg_pressure` = DBT_INTERNAL_SOURCE.`avg_pressure`,`inserted_at` = DBT_INTERNAL_SOURCE.`i
nserted_at`
when not matched then insert
(`week_start_sunday`, `avg_temp`, `avg_humidity`, `avg_wind_speed`, `avg_pressure`, `inserted_at`)
values
(`week_start_sunday`, `avg_temp`, `avg_humidity`, `avg_wind_speed`, `avg_pressure`, `inserted_at`)Повне оновлення (full refresh)
Якщо потрібно запустити модель заново з нуля, можна виконати dbt run --full-refresh.
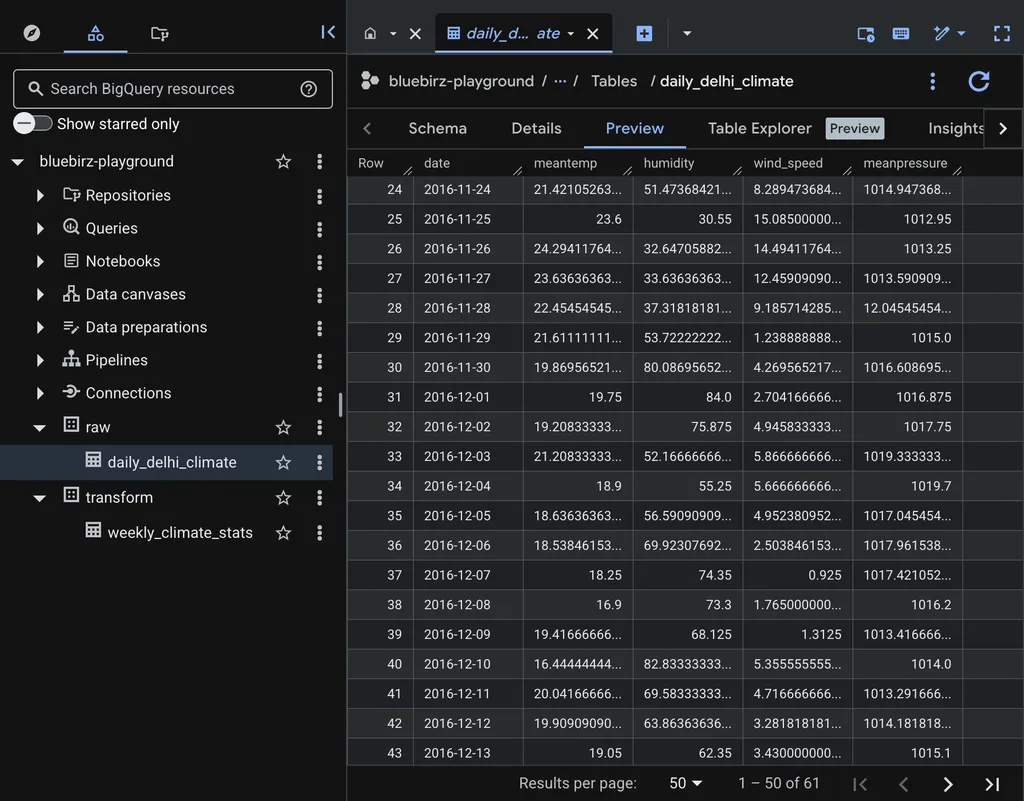
source
Тепер ми використовуємо оновлене джерело, у якому є дані за листопад і грудень 2016 року.
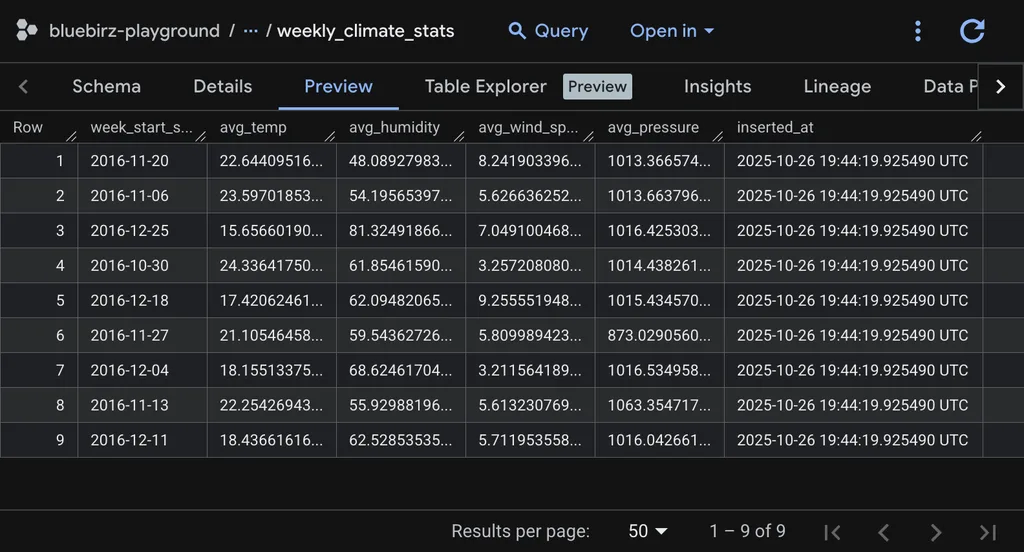
result
Після виконання dbt run --full-refresh ми отримали нову таблицю, схожу на результат попереднього запуску, але цього разу в усіх рядках однакове значення inserted_at, адже таблицю було перестворено.
final query
$ cat target/run/dbt_proj01/models/climate/weekly-delhi-climate.sql

    create or replace table `bluebirz-playground`.`transform`.`weekly_climate_stats`


    OPTIONS()
    as (
      select date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
    current_timestamp() as inserted_at
from `bluebirz-playground`.`raw`.`daily_delhi_climate`

group by all
);Матеріалізація: Ephemeral (Ефемерна)
Коли потрібна віртуальна модель, яка виконує певні завдання і може використовуватися повторно, варто розглянути ephemeral-моделі, що працюють як функції для багаторазового використання. dbt збирає такі моделі як CTE (Common Table Expression, спільний табличний вираз), тому ми не бачимо їхнього кінцевого результату в базі даних, але можемо звертатися до них через ref().
ephemeral model
Додаємо materialized='ephemeral', і модель готова.
{{-
    config(
        materialized="ephemeral",
    )
-}}
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
from {{ source("delhi_climate", "daily_delhi_climate") }}
group by allcaller model
Використовуємо ephemeral-модель через ref('<ephemeral_filename>').
{{-
    config(
        schema="transform",
        alias="weekly_climate_stats",
        materialized="table",
    )
-}}
select *
from {{ ref("weekly_climate_compute_cte") }}compiled result
Ephemeral-модель перетворюється на CTE з префіксом __dbt__cte__.
with __dbt__cte__weekly_climate_compute_cte as (
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
from `bluebirz-playground`.`raw`.`daily_delhi_climate`
group by all
) select *
from __dbt__cte__weekly_climate_compute_cteМатеріалізація: Materialized View (Матеріалізоване представлення)
Матеріалізоване представлення (materialized view) — це розширений різновид view, який попередньо обчислює і зберігає результати запиту. Водночас матеріалізовані представлення підтримують обмежений набір можливостей SQL, наприклад AVG, SUM, COUNT тощо, але не підтримують віконні функції, користувацькі функції та інше.
До матеріалізованих подань варто вдаватися, коли потрібні попередньо обчислені дані, але також хочеться мати view з агрегаціями, з’єднаннями та фільтрами, щоб можна було гнучко змінювати запит без збереження даних у фізичних таблицях.
За документацією BigQuery, матеріалізовані представлення можна налаштовувати[3] за допомогою таких параметрів:
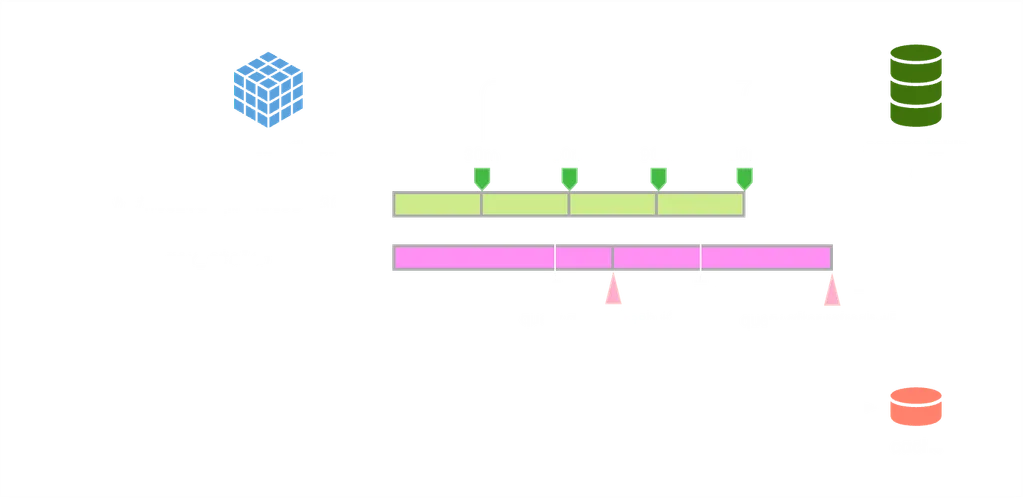
enable_refreshдозволяє BigQuery автоматично оновлювати це матеріалізоване представлення, коли змінюються вихідні таблиці.refresh_interval_minutes— проміжок часу в хвилинах, з яким матеріалізоване представлення оновлюється з вихідних таблиць.max_staleness[6] [7] — допустимий проміжок «застарілості» даних: якщо останнє оновлення було раніше за цей період, представлення звертається до вихідних таблиць, інакше використовує кешовані дані.
model
Матеріалізоване представлення визначаємо через materialized='materialized_view' та інші параметри конфігурації, описані вище.
{{-
    config(
        schema="transform",
        alias="weekly_climate_stats",
        materialized="materialized_view",
        on_configuration_change="apply",
        enable_refresh=True,
        refresh_interval_minutes=180,
        max_staleness="INTERVAL '4:0:0' HOUR TO SECOND",
    )
-}}
select
    date_trunc(date, week(sunday)) as week_start_sunday,
    avg(meantemp) as avg_temp,
    avg(humidity) as avg_humidity,
    avg(wind_speed) as avg_wind_speed,
    avg(meanpressure) as avg_pressure,
from {{ source("delhi_climate", "daily_delhi_climate") }}
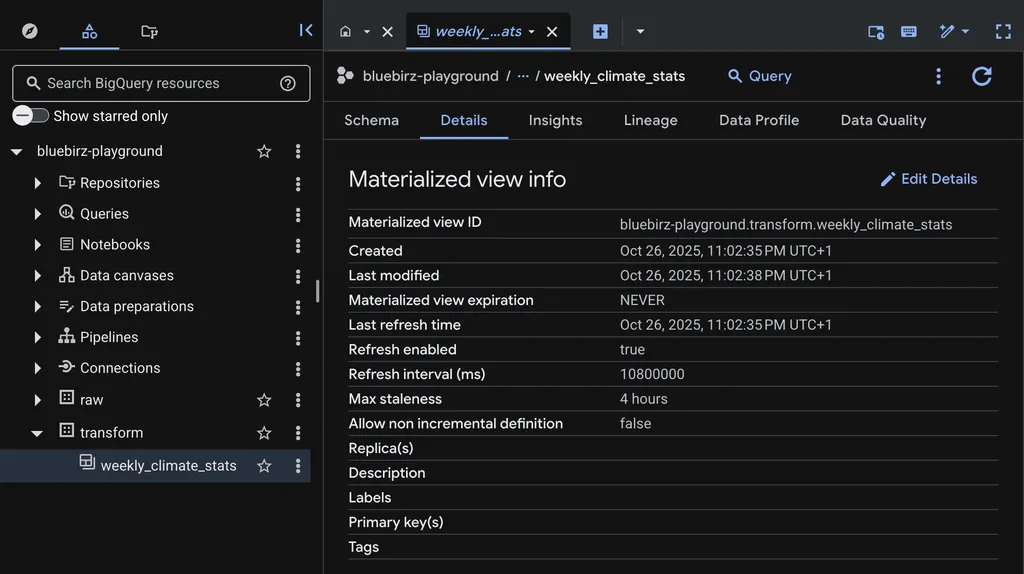
group by allresult
Після виконання dbt run ми маємо побачити нове матеріалізоване представлення.
💡 Поради
- Розгляньте партиціоновані таблиці як вихідні, щоб зменшити вартість і час оновлення.
- Налаштуйте
refresh_interval_minutesвідповідно до частоти оновлення вихідних таблиць.
Наприклад, якщо нові дані в джерелі з’являються кожні 2 години, можна встановити 180 хвилин: 2 години + 1 година запасу = 3 × 60 = 180 хвилин. - Налаштуйте
max_stalenessзалежно від того, як ви використовуєте дані.
Наприклад, якщо дашборди працюють з 9:00 до 10:00 ранку, а матеріалізовані представлення оновлюються о 7:00, можна встановити 4 години, щоб дашборди використовували кеш.
Підсумок
- Типи матеріалізації можна налаштовувати в:
dbt_project.yml;- файлах моделей через
{{ config(materialized='') }};
- YAML-файлах властивостей (наприклад,
property.yml). - view:
{{ config(materialized='view') }}, щоб створити view.
- table:
{{ config(materialized='table') }}, щоб створити таблицю з повним завантаженням.
- incremental:
{{ config(materialized='incremental') }}, щоб створити інкрементальну модель.{{ config(incremental_strategy='<strategy>') }}, щоб визначити, як обробляти інкрементальні дані.{{ config(unique_key=["<field1>", "<field2>", ...]) }}, щоб задати унікальні поля для інкрементальних даних.is_incremental()керує додатковою логікою вибору інкрементальних даних і повертаєtrue, коли ця інкрементальна модель запускається на вже існуючій таблиці без прапорця--full-refresh.dbt run --full-refreshзапускає всі інкрементальні моделі заново з нуля.{{ this }}посилається на саму модель.
- ephemeral:
{{ config(materialized='ephemeral') }}, щоб створити ephemeral-модель.- на ephemeral-модель посилаємося через
{{ ref('<ephemeral_filename>') }}.
- materialized view:
{{ config(materialized='materialized_view') }}, щоб створити матеріалізоване представлення;enable_refresh, refresh_interval_minutes і max_stalenessвизначають, як і коли воно оновлюється.
Джерела
- Матеріалізації
- Про стратегію інкрементального оновлення
- Оптимізація матеріалізованих подань за допомогою dbt
- Автоматичне оновлення
- Встановлення обмеження частоти оновлення
- Використання матеріалізованих подань з опцією max_staleness
- Параметри Max_Staleness
ОРИГІНАЛ СТАТТІ: Let’s try: dbt part 4 – model materialization
АВТОР СТАТТІ: bluebirz
Оригінал опубліковано під ліцензією CC BY 4.0. Цей матеріал є перекладом українською мовою.
Доєднуйтесь до наших спільнот 👇